状況によっては、効率を上げるために複数の独立したタスクを同時に実行する必要があります。並列タスクワークフローは、この目的のために設計されています。これにより、複数のAI Agentが同じ初期情報に対して同時に作業でき、個々の結果が最後に収集・結合されます。
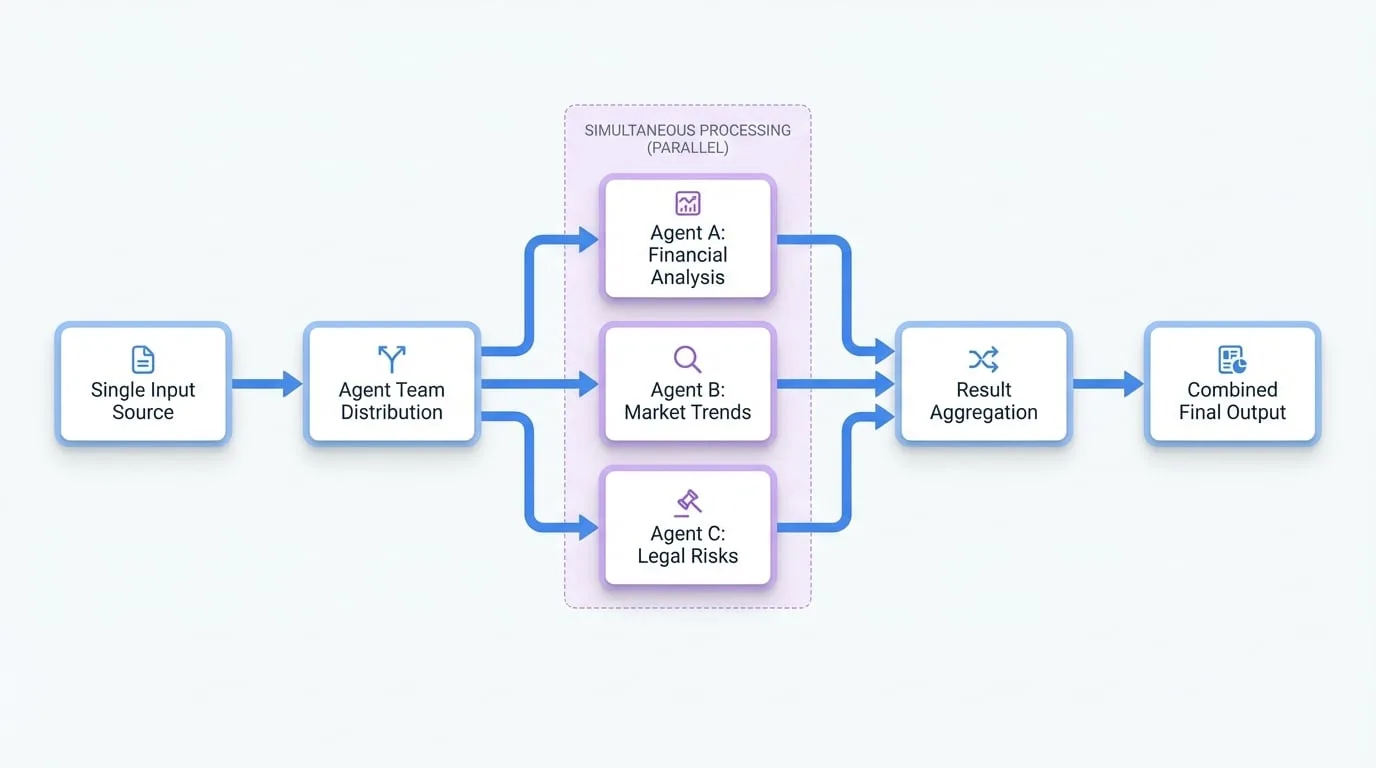
このアプローチは、ビジネス提案を分析するために専門家チームを雇うようなものです。ある専門家は財務的な実行可能性に、別の専門家は市場動向に、そして3人目は法務リスクに焦点を当てるかもしれません。彼らは全員が同じ提案から始め、同時に作業を進め、最終的なレポートがまとめられて全体像が示されます。これは、互いの作業が終わるのを待たなければならない場合に比べて、はるかに高速です。
このワークフローは、並列モードで動作するように構成された Agentチーム によって管理されます。タスクを次々と実行する別のアプローチについては、シーケンシャルタスク ワークフローを参照してください。
仕組み
並列ワークフローは、互いに依存しないタスクを処理するための、明確で効率的なプロセスに従います。このフローは、すべてのAgentを一度に実行することで速度を最大化するように設計されています。
単一の入力
プロセスは、ドキュメント、ユーザーからのクエリ、またはデータセットといった単一の情報から始まります。
同時配信
Agentチームはこの入力を受け取り、チーム内のすべてのAgentに全く同じ情報を配信します。
独立した処理
すべてのAgentが同時に作業を開始します。各Agentは、他のAgentを待ったり、相互作用したりすることなく、独自の指示に基づいて専門のタスクを実行します。
結果の集約
各Agentが作業を終えると、その出力が収集されます。その後、Agentチームはこれらの個々の出力を単一の結合された結果に集約します。複数のAgentが同じフィールドの出力を生成した場合、通常、システムは最初に完了したAgentの結果を受け入れます。
この構造により、すべてのタスクを完了するために必要な合計時間は、全Agentの時間の合計ではなく、最も長く実行されているAgentによって決定されます。
一般的なユースケース
並列ワークフローは、同じ情報に対して複数の独立した分析やタスクが必要で、かつ速度が優先されるシナリオに最適です。
多角的なコンテンツ分析
ドキュメントを分析する際、あるAgentは主要な特徴を抽出し、別のAgentは感情的なトーン(センチメント)を分析し、3番目のAgentはターゲットオーディエンスを特定することができます。これら3つのタスクはすべて同時に実行可能です。
並列データクエリ
異なるソース(例:顧客データベース、製品カタログ、ナレッジベース)にまたがって情報を検索する必要がある場合、各ソースに対してAgentを派遣し、同時に検索させることができます。
競合分析
競合他社の製品を分析するために、あるAgentは最近の顧客レビューを収集し、別のAgentは価格情報を見つけ、3番目のAgentは技術仕様を調べるといったことを、すべて並行して行うことができます。
コードレビュー
あるコードに対して、1つのAgentがセキュリティの脆弱性をチェックし、別のAgentがスタイルガイドラインへの準拠をチェックします。その後、フィードバックは開発者のために結合されます。
まとめ
並列タスクワークフローは、効率を向上させるための強力なパターンです。複数のAgentが独立して同時に作業できるようにすることで、関連性のない複数のサブタスクを含む複雑なジョブを完了するのに必要な時間を大幅に短縮します。これにより、応答性が高く強力なAIアプリケーションを構築するための基本的なワークフローとなります。
Agentが異なる方法で連携する様子を確認するには、次にシーケンシャルタスクワークフローについてお読みください。