Orchestrator Agent は、複雑で複数ステップにわたる AI ワークフローを管理するための、構造化された信頼性の高いソリューションを提供します。高レベルの目標を一連の管理可能なタスクに分解し、それらを順次実行し、その結果を最終的で一貫性のある応答に統合することで、自律的なタスク計画と実行を可能にします。
このドキュメントでは、Orchestrator Agent のアーキテクチャ、設定、および実践的な応用について詳しく説明します。
概要
Orchestrator Agent は、Planner → Worker → Completer という 3 フェーズのアーキテクチャを使用して、自律的なタスク管理のための高度なパターンを実装しています。この構造により、複数のステップ、ツール、および反復的な改良が必要な複雑な目標を処理できます。
コアコンポーネントは次のとおりです。
- Planner: 主な目標と現在の進捗状況を分析し、最も論理的な次のタスクを決定します。
- Worker: Planner から割り当てられた特定のタスクを、利用可能なツールやスキルを使用して実行します。
- Completer: すべてのタスクが完了すると、実行履歴全体を確認し、個々の結果を最終的で包括的な出力に統合します。
- Execution State: ワークフロー中に実行されたすべてのタスクの履歴、ステータス、および結果を追跡する記録管理コンポーネントです。
この反復プロセスは、Planner が全体的な目標が達成されたと判断するまで続きます。
アーキテクチャ
ワークフローは、目標が達成されるまで Planner と Worker が協調するループであり、その後に Completer による最終的な統合ステップが続きます。次の図は、このプロセスを示しています。
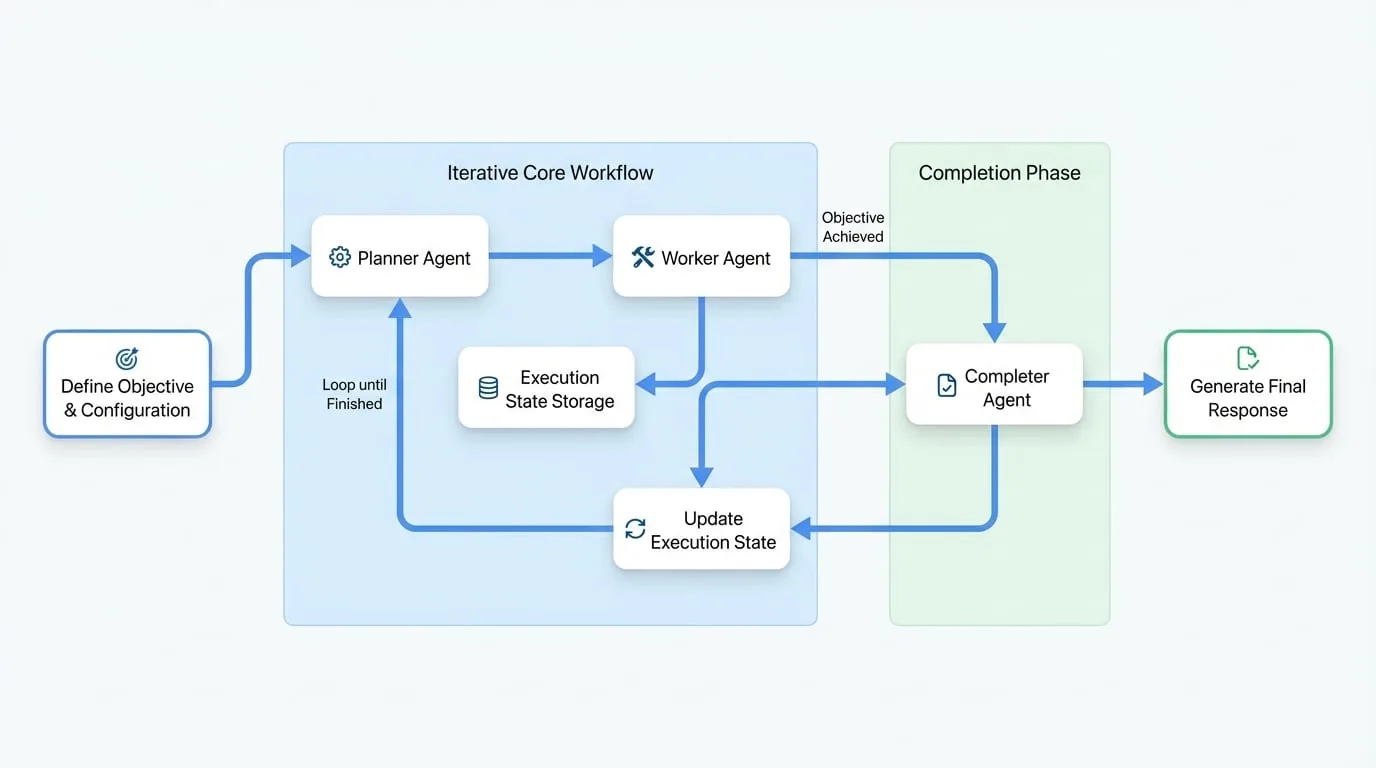
プロセスは次のように展開されます。
初期化
Orchestrator は高レベルの目標を受け取り、空の実行状態を初期化します。
計画
Planner は目標と現在の状態(初期状態は空)を調査し、最初のタスクを考案します。
実行
Worker は Planner からタスクを受け取り、それを実行します。結果(成功または失敗、および結果またはエラー)が記録されます。
状態の更新
タスクの結果が実行状態に追加されます。
反復
プロセスはステップ 2 から繰り返されます。Planner は目標と実行状態の更新された履歴を確認して、次のタスクを決定します。
完了
Planner が目標が完了したと判断すると、ループの終了を通知します。その後、Completer が引き継ぎ、実行状態の完全な履歴を確認し、最終的な応答を生成します。
基本的な使い方
Orchestrator Agent を設定する最も直接的な方法は、YAML 定義ファイルを使用することです。
設定例
以下は、プロジェクト構造を分析するオーケストレーターを作成するための基本的な設定です。
agents/orchestrator.yaml
type: "@aigne/agent-library/orchestrator"
name: orchestrator

# Agent の全体的な目標を定義します。
# よりクリーンな分離のために外部ファイルを使用できます。
objective:
  url: objective.md

# ワークフローの実行を制御するために状態管理を設定します。
state_management:
  max_iterations: 20      # 計画-実行サイクルの上限を設定します。
  max_tokens: 100000      # 実行状態コンテキストのトークン上限を設定します。
  keep_recent: 20         # 状態を圧縮する際に、最新の 20 タスクを保持します。

# Agent File System (AFS) を設定して、ワークスペースを提供します。
afs:
  modules:
    - module: local-fs
      options:
        name: workspace
        localPath: .
        description: Orchestrator Agent のワークスペースディレクトリ。
objective.md ファイルには、Agent の主要な目標が含まれています。
agents/objective.md
プロジェクトの構造を分析し、包括的なレポートを生成してください。

- node_modules、.git、dist、build ディレクトリは無視してください。
- 実際のファイル内容に基づいた正確な情報を提供してください。
- 主要な発見事項と推奨事項を含めてください。

{% if message %}
## ユーザーの指示
{{ message }}
{% endif %}
最後に、メインの aigne.yaml ファイルがすべてをまとめます。
aigne.yaml
#!/usr/bin/env aigne

model: google/gemini-1.5-pro
agents:
  - agents/orchestrator.yaml
設定リファレンス
Orchestrator Agent は、その動作、コンポーネント、および制約を定義する一連のオプションを通じて設定されます。
トップレベルオプション
- objective
PromptBuilder(required) — オーケストレーターが達成すべき全体的な目標。 - planner
Agent— 計画フェーズを処理するカスタム Agent。指定されない場合、デフォルトのプランナーが使用されます。 - worker
Agent— 実行フェーズを処理するカスタム Agent。指定されない場合、デフォルトのワーカーが使用されます。 - completer
Agent— 完了フェーズを処理するカスタム Agent。指定されない場合、デフォルトのコンプリーターが使用されます。 - stateManagement
object— 実行状態を管理するための設定。 - inputSchema
ZodSchema— 入力データを検証するためのスキーマ。目標テンプレートでカスタム変数を使用する場合に必要です。 - outputSchema
ZodSchema— コンプリーターからの最終出力を検証するためのスキーマ。 - afs
AFSOptions— Agent File System の設定。すべてのコンポーネントがファイルやディレクトリを利用できるようにします。 - skills
Agent[]— ワーカー Agent が利用できるツールやスキルのリスト。 - model
string— コンポーネントの特定の設定で上書きされない限り、すべてのコンポーネント(プランナー、ワーカー、コンプリーター)で使用されるデフォルトのモデル。
Note
objective プロンプトで {{ message }} のようなカスタム入力変数を使用する場合、inputSchema でそれらを宣言する必要があります。宣言されていない変数はテンプレートに渡されません。
StateManagementOptions
これらのオプションは、実行ループを制御し、無限実行やコンテキストのオーバーフローを防ぎます。
- maxIterations
number(default:20) — 実行する計画-実行サイクルの最大数。 - maxTokens
number— Agent に渡される実行状態履歴に許可される最大トークン数。 - keepRecent
number— トークン制限により状態が圧縮される際に保持する最近のタスクの数。
コンポーネントのカスタマイズ
デフォルトの Planner、Worker、または Completer を独自のカスタム Agent に置き換えることで、オーケストレーターのロジックを特定のドメインに合わせて調整できます。これは通常、カスタムの指示を持つ AI Agent を作成することによって行われます。
カスタム Planner
Planner の役割は、次のアクションを決定することです。
- 標準入力:
objective、skills、executionState。 - 標準出力:
nextTask(文字列) とfinished(ブール値) を含むオブジェクト。
設定例:
agents/orchestrator.yaml
type: "@aigne/agent-library/orchestrator"
objective:
  url: objective.md
planner:
  type: ai
  instructions:
    url: custom-planner.md
指示の例 (custom-planner.md):
## あなたの役割
あなたはコード分析タスクの戦略的プランナーです。あなたの責任は、全体的な目標と完了したタスクの履歴に基づいて、実行すべき次の単一のタスクを決定することです。

## 目標
{{ objective }}

## 利用可能なスキル
{{ skills | yaml.stringify }}

## 現在の実行状態
{{ executionState | yaml.stringify }}

## 計画ガイドライン
- `executionState` を確認して、作業の重複を避けてください。
- 目標を小さく、論理的なステップに分解してください。
- 一度に 1 つのタスクのみを計画してください。
- すべての作業が完了した場合は、`finished: true` を設定してください。

## 出力フォーマット
次のフィールドを持つ JSON オブジェクトを返してください:
- `nextTask`: 実行する次のタスクを説明する文字列。完了した場合はこのフィールドを省略します。
- `finished`: 目標が完了したかどうかを示すブール値。
カスタム Worker
Worker の役割は、単一のタスクを実行することです。
- 標準入力:
objective、task、executionState。 - 標準出力:
success(ブール値)、result(文字列、成功時)、およびerror(messageを持つオブジェクト、失敗時) を含むオブジェクト。
設定例:
agents/orchestrator.yaml
# ...
worker:
  type: ai
  instructions:
    url: custom-worker.md
指示の例 (custom-worker.md):
## あなたの役割
あなたはプロのコード分析ワーカーです。あなたの仕事は、利用可能なツールを使用して割り当てられたタスクを実行することです。

## 全体的な目標 (コンテキストのみ)
{{ objective }}

## 現在のタスク
{{ task }}

## 実行ガイドライン
- `現在のタスク` の完了に厳密に集中してください。
- 提供されたツールとスキルを使用してタスクを達成してください。
- 成功した場合は結果を提供してください。失敗した場合は、エラーメッセージで失敗を説明してください。

## 出力フォーマット
次のフィールドを持つ JSON オブジェクトを返してください:
- `success`: タスクが成功したかどうかを示すブール値。
- `result`: タスクの出力を含む文字列。成功時に必須です。
- `error`: `message` フィールドを持つオブジェクト。失敗時に必須です。
カスタム Completer
Completer の役割は、最終レポートを統合することです。
- 標準入力:
objective、executionState。 - 標準出力: ユーザー定義の構造。オーケストレーターの
output_schemaに対して検証されます。
設定例:
agents/orchestrator.yaml
# ...
completer:
  type: ai
  instructions:
    url: custom-completer.md
  output_schema:
    type: object
    properties:
      summary:
        type: string
        description: An executive summary of the findings.
      recommendations:
        type: array
        items:
          type: string
        description: A list of actionable recommendations.
    required: [summary]
指示の例 (custom-completer.md):
## あなたの役割
あなたは、実行履歴からすべてのタスク結果を最終的で構造化された応答に統合する責任があります。

## ユーザーの目標
{{ objective }}

## 実行結果
{{ executionState | yaml.stringify }}

## 統合ガイドライン
- `executionState` 内の成功したタスクと失敗したタスクをすべて分析してください。
- 個々の結果を、一貫性のあるレポートに統合してください。
- 定義された出力スキーマに従って応答を構造化してください。

## 出力フォーマット
出力スキーマに準拠した JSON オブジェクトを返してください。
ベストプラクティス
Orchestrator Agent の効果を最大化するために、以下の原則に従ってください。
1. 明確な目標を定義する
具体的で、実行可能で、曖昧さのない目標を提供してください。明確に定義された目標は、Planner が論理的なタスクシーケンスを作成するために不可欠です。
- 良い例: 「
/src/authの認証システムを分析し、セキュリティの脆弱性を特定し、見つかった各問題に対して具体的な推奨事項を提供する。」 - 悪い例: 「コードを見て、何が悪いか教えて。」
2. コンポーネントの役割を特化させる
各コンポーネントが指定された役割に集中するようにしてください。Planner は計画のみを行い、実行は行いません。Worker は現在のタスクのみを実行し、将来のタスクを計画しません。
3. 長いワークフローには状態圧縮を使用する
多くの反復が必要になる可能性のある複雑な目標については、コンテキストがモデルにとって大きくなりすぎるのを防ぐために状態管理を設定してください。
state_management:
  max_iterations: 50
  max_tokens: 80000      # コンテキストのオーバーフローを防ぐ
  keep_recent: 25        # コンテキストのために最近のタスク履歴を保持する
4. コンポーネントごとに異なるモデルを使用する
各コンポーネントのニーズに基づいて異なるモデルを割り当てることで、コストとパフォーマンスを最適化します。計画と統合には強力なモデルを、実行にはより速く安価なモデルを使用することが、多くの場合コスト効果の高い戦略です。
planner:
  type: ai
  model: anthropic/claude-3-5-sonnet-20240620

worker:
  type: ai
  model: google/gemini-1.5-flash

completer:
  type: ai
  model: anthropic/claude-3-5-sonnet-20240620
5. 入力と出力を検証する
input_schema と output_schema を使用して型安全性を強制し、Agent が期待される形式でデータを受け取り、生成することを保証します。これは、目標プロンプトがテンプレート変数を使用する場合に特に重要です。