本文件提供聊天補全 API 端點的詳細規格。遵循本指南,您將學習如何生成對話式 AI 回應、管理串流以及利用模型特定參數來建構穩健的應用程式。此端點是建立互動式、基於文字體驗的核心。
聊天補全 API 讓您能夠建構應用程式,利用大型語言模型處理各種對話任務。您提供一系列訊息作為輸入,模型會回傳一個基於文字的回應。
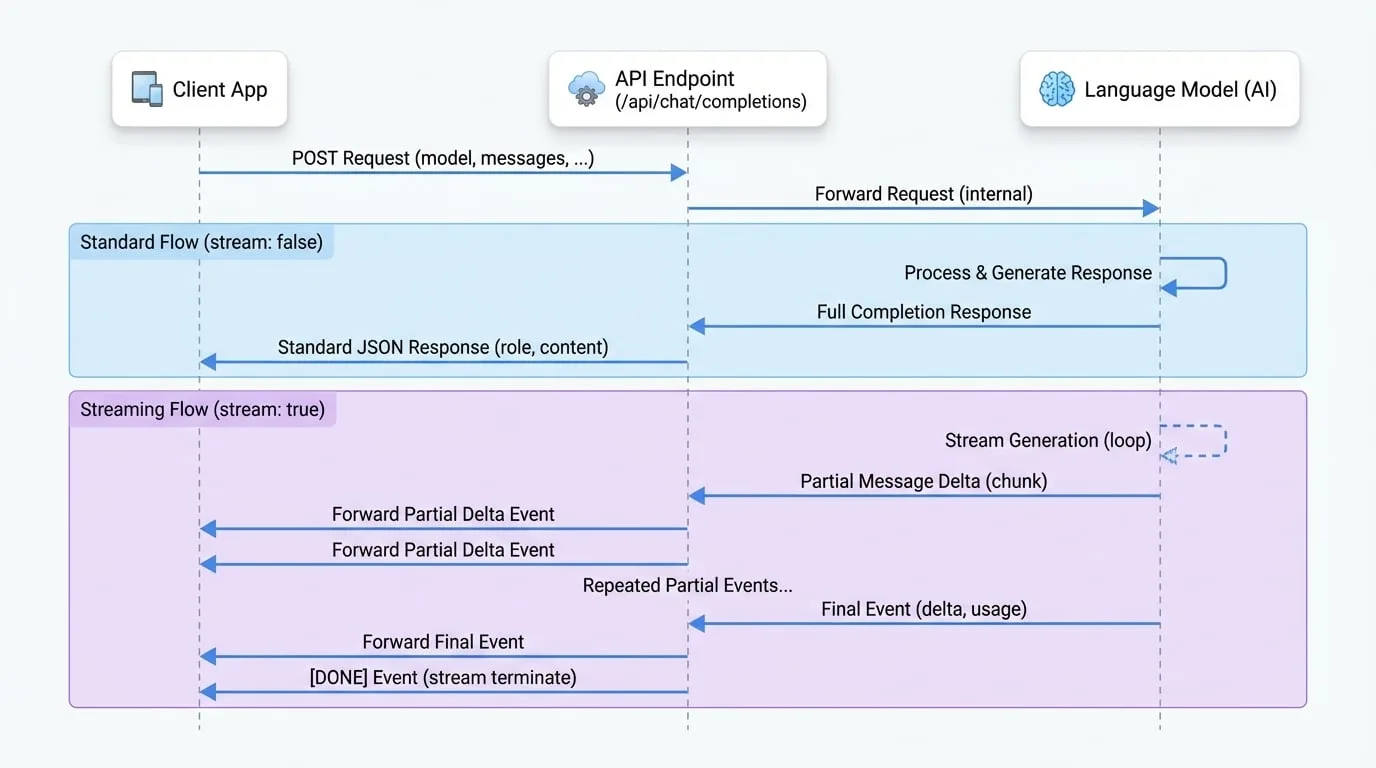
下圖說明了標準和串流 API 呼叫的請求與回應流程:
建立聊天補全
為給定的聊天對話建立模型回應。
POST /api/chat/completions
請求主體
- model
string(required) (default:gpt-3.5-turbo) — 要使用的模型 ID。請參閱模型端點相容性表,以了解哪些模型適用於聊天 API。 - messages
array(required) — 構成目前為止對話的訊息列表。訊息物件結構請見下方。- message
object— 每個訊息物件都必須有 role 和 content。- role
string(required) — 訊息作者的角色。可以是 system、user、assistant 或 tool。 - content
string or array(required) — 訊息的內容。對於多模態模型,這可以是一個字串或一個由內容部分組成的陣列(例如文字和圖片 URL)。 - name
string— 參與者的可選名稱。為模型提供有關訊息作者的上下文。 - tool_calls
array— 模型生成的工具呼叫,例如函數呼叫。 - tool_call_id
string— 如果角色是 tool 則為必填。此訊息所回應的工具呼叫的 ID。
- role
- message
- temperature
number(default:1) — 控制隨機性。降低此值會導致補全結果較不隨機。當溫度接近零時,模型將變得確定性且重複。範圍:0 到 2。 - top_p
number(default:1) — 透過核心取樣控制多樣性。0.5 表示只考慮經可能性加權後的一半選項。範圍:0.1 到 1。 - stream
boolean(default:false) — 如果設為 true,部分訊息增量將以伺服器發送事件 (server-sent events) 的形式傳送。串流以 data: [DONE] 訊息終止。 - max_tokens
integer— 要生成的最大 token 數量。輸入 token 和生成 token 的總長度受模型的上下文長度限制。 - presence_penalty
number(default:0) — 介於 -2.0 和 2.0 之間的數字。正值會根據新 token 是否已在目前的文本中出現來對其進行懲罰,從而增加模型談論新話題的可能性。 - frequency_penalty
number(default:0) — 介於 -2.0 和 2.0 之間的數字。正值會根據新 token 在目前文本中的現有頻率對其進行懲罰,從而降低模型逐字重複同一句話的可能性。 - tools
array— 模型可以呼叫的工具列表。目前僅支援函數作為工具。 - tool_choice
string or object— 控制模型呼叫哪個(或是否呼叫)工具。可以是 'none'、'auto'、'required' 或一個指定要呼叫的函數的物件。 - response_format
object— 一個指定模型必須輸出的格式的物件。設定為 { "type": "json_object" } 可啟用 JSON 模式。
範例
基本請求
此範例展示了與模型進行的簡單對話。
cURL 請求
curl --location 'https://your-aigne-hub-instance.com/api/chat/completions' \
--header 'Authorization: Bearer YOUR_API_KEY' \
--header 'Content-Type: application/json' \
--data '{
    "model": "gpt-3.5-turbo",
    "messages": [
        {
            "role": "system",
            "content": "You are a helpful assistant."
        },
        {
            "role": "user",
            "content": "Hello! Can you explain what AIGNE Hub is in simple terms?"
        }
    ]
}'
串流請求
若要以事件串流的形式接收回應,請將 stream 參數設為 true。
cURL 串流請求
curl --location 'https://your-aigne-hub-instance.com/api/chat/completions' \
--header 'Authorization: Bearer YOUR_API_KEY' \
--header 'Content-Type: application/json' \
--header 'Accept: text/event-stream' \
--data '{
    "model": "gpt-3.5-turbo",
    "messages": [
        {
            "role": "user",
            "content": "Write a short story about a robot who discovers music."
        }
    ],
    "stream": true
}'
回應主體
標準回應
當 stream 為 false 或未設定時,會回傳一個標準的 JSON 物件。
- role
string— 此訊息作者的角色,固定為 'assistant'。 - content
string— 模型生成的訊息內容。 - tool_calls
array— 模型生成的工具呼叫(如果有的話)。
標準回應範例
回應主體
{
  "role": "assistant",
  "content": "AIGNE Hub 是一個集中式閘道,用於管理與來自不同提供商的各種 AI 模型的互動。它簡化了 API 存取、處理計費和點數,並提供使用量和成本的分析,作為組織 AI 服務的單一控制點。"
}
串流回應
當 stream 為 true 時,API 會回傳一個 text/event-stream 區塊的串流。每個區塊都是一個 JSON 物件。
- delta
object— 訊息增量的一個區塊。- role
string— 作者的角色,通常是 'assistant'。 - content
string— 訊息的部分內容。 - tool_calls
array— 部分的工具呼叫資訊。
- role
- usage
object— 出現在最後一個區塊中,包含 token 使用統計資訊。- prompt_tokens
integer— 提示中的 token 數量。 - completion_tokens
integer— 生成的補全中的 token 數量。 - total_tokens
integer— 請求中使用的 token 總數。
- prompt_tokens
串流區塊範例
事件串流
data: {"delta":{"role":"assistant","content":"Unit "}}

data: {"delta":{"content":"734,"}}

data: {"delta":{"content":" a sanitation "}}

data: {"delta":{"content":"and maintenance "}}

data: {"delta":{"content":"robot, hummed..."}}

data: {"usage":{"promptTokens":15,"completionTokens":100,"totalTokens":115}}

data: [DONE]
總結
聊天補全端點是將對話式 AI 整合到您的應用程式中的強大工具。它透過各種參數(包括串流和工具使用)提供靈活性,以支援廣泛的使用案例。
有關其他可用 API 端點的更多資訊,請參閱以下文件: