GraphQL 將驅動去中心化網路
利用區塊鏈與儲存網路作為資料互通層
作者:Brandon Ramirez
幾十年來,SQL 資料庫是市面上唯一被廣泛使用的資料庫,且至今仍是大多數組織、軟體應用程式與機構的核心。然而,隨著區塊鏈的出現,關聯式資料庫終於有了替代方案,我指的不僅僅是 NoSQL 運動帶來的漸進式改進。我們正處於一個被稱為「去中心化網路」或 Web3 的新範式邊緣,在這裡,資料而非專有 API,才是互通性的根本基底。在這篇文章中,我將解釋為什麼這種轉變正在發生,以及 GraphQL 查詢語言如何具備獨特優勢來驅動這個資料互通的新時代。
專有 API 的問題
當今的網路是透過專有的應用程式介面(API)連接的,這些 API 的存在主要是為了克服中心化(通常是 SQL)資料庫的限制。前以太坊基金會(Ethereum foundation)成員 Vinay Gupta 在描述現狀時觀察到:
「當你的組織核心有一個儲存了所有真理與智慧的大型單一資料庫時,你會非常不情願讓其他人碰那個資料庫。」
因此,運行在伺服器上的專有 API 充當了中心資料庫的保護屏障。它們限制了誰能在什麼時間、以什麼格式輸入或輸出資料。在微服務模式下,我們甚至將資料封裝在組織內部,使得不同團隊建立的服務必須透過彼此的 API 進行溝通。雖然這成就了我們今天的發展,但這種 API 的擴張具有以下缺點:
- API 僵化且維護成本高昂。
- 當前的模式效率低下。
- 專有 API 導致資料壟斷。
讓我們更深入地探討這些問題。
1. API 僵化且維護成本高昂
API,特別是 REST API(稍後會詳細說明),是針對特定使用案例設計的(例如網頁應用程式中的某個功能),當你越偏離這些使用案例,它們就越難使用。
在組織內部,這導致 API 的表面積不斷擴大。每個新功能都需要額外的工程工作來增加新的端點(endpoint)。反過來,每個新端點在其使用期間(這可能是一段很長的時間)都需要持續的工程工作來維護和支援。
與此同時,對於公共 API 的消費者來說,他們被困在 API 開發者決定支援的使用案例中。Github 的生態系統工程總監 Kyle Daigle 清楚地說明了這個問題:
「幾乎每個 API 的設計都驅動了整合方式……我能想到的每個 API……它們對於希望你如何使用它都有一定的想法,如果你想顛覆這一點,基本上是不可能的……你必須去爬取大量的資料庫,將其放入資料庫中,然後基本上圍繞它建立自己的 API。」
這些公共 API 的僵化需要大量的額外工程努力來繞過,這引出了我們的下一點。
2. 當前的模式效率低下
正如我們所見,API 的僵化導致了更多資料庫和 API 的擴張,通常是為了儲存完全相同的資料,只是格式不同或採用不同的 API 語意。這些新的資料庫和 API 中的每一個都需要額外的基礎設施和工程資源來維護。
這也導致了驚人的間接性。再次引用 Vinay Gupta 的話:
「當你向國稅局(IRS)提交表格時,它會經過 6 或 7 個程序才最終進入他們的資料庫……整個協作是間接的、官僚的、困難的。」
Brendan O’Brien 和 Michael Hucka 在他們描述研究資料領域中此問題的論文中,將 SQL 資料庫的主導地位描述為「中間資料庫(database in the middle)」模式,如下圖所示:
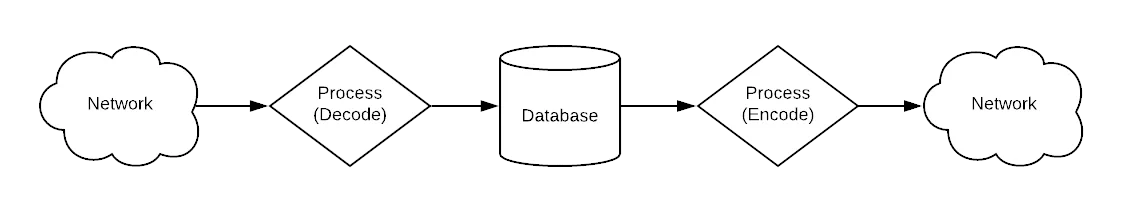
「中間資料庫模式」,改編自:https://qri.io/papers/deterministic_querying/
任何稍微複雜的軟體系統都會涉及無數台伺服器:從一個資料庫中編碼資料、透過網路傳輸、解碼資料、放入另一個資料庫,並多次重複此過程。
O’Brien 和 Hucka 接著描述了在這些資料流水線中,中間結果通常會被儲存在私有資料庫中或被完全丟棄,因為使這些資料公開可用需要付出巨大的工程努力。其結果是兩個維度的重複:在資料流水線內部,以及由孤立團隊和組織建立的資料流水線之間。
3. 專有 API 導致資料壟斷
將資料置於孤島的必要性也導致了道德風險。這已成為科技圈常見的敘事:某家科技巨頭在之前鼓勵開發者在其平台上構建應用後,又撤銷了對其專有 API 的訪問權限。
Facebook 這麼做是為了刻意扼殺競爭,而 Twitter 則是為了更有效地將其資料貨幣化。InfoWorld 的資深作家 Serdar Yegulalp 報導了 Twitter 的故事,簡練地描述了建立在專有 API 上的風險:
「這可以稱為 API 經濟的職業風險之一:對單一實體(無論是作為資料源、分析層還是基礎設施)的依賴越廣泛且多方面,地毯就越容易從你腳下被抽走(讓你措手不及)。」
這種要求資料隱藏在守門人之後的軟體架構範式,自然會誘發這些資料壟斷者的有害行為。
為了公平起見,我應該指出基於 API 的連接已經取得了巨大的成功。API 透過讓開發者能夠從 Stripe 或 Twilio 等較小的專用服務組合軟體,創造了無法估量的經濟價值。在由 SQL 主導的傳統技術領域,它們為我們提供了一種在應用程式之間安全傳輸資料的方法。如果沒有 API,我們今天所知並熱愛的網際網路將不復存在。但現在,隨著區塊鏈和其他 Web3 技術的出現,我們有機會進入一個網際網路無障礙互通的新時代。
進入區塊鏈與內容定址儲存
SQL 以及大多數 NoSQL 資料庫的缺點核心在於其採用了就地(in place)更改資料的資訊模型。Clojure 程式語言和 Datomic 資料庫的創造者 Rich Hickey 將此稱為「面向位置的編程(place-oriented programming, PLOP)」。雖然這在以前為了克服記憶體和磁碟容量小的限制是必要的,但在現代資訊模型中已不再適用。當資料可以以任意方式就地更改時,就無法信任資料是正確的,也無法保證資料自上次訪問以來沒有發生變化。因此,去中心化網路的兩項賦能技術——區塊鏈和內容定址儲存(content-addressed storage)——都在其資訊模型中強調「不可變性(immutability)」,也就不足為奇了。
內容定址儲存
雖然區塊鏈的熱度更高,但我將從解釋內容定址儲存開始,因為它是更簡單且更基礎的概念。這個想法是:對於任何一段資料——資料庫中的一個實體、檔案系統中的一個檔案、CDN 上的一個大型二進位物件(blob)——你如何引用該資料?你是給它一個隨意的 ID、一個 URL 或一個名稱(這些名稱可能會根據你的請求方式在不同時間指向不同的資料),還是給它一個唯一的 ID,無論它從哪裡提供(本地檔案系統、遠端伺服器或另一個星球),該 ID 都將永遠解析為特定的值?
內容定址儲存網路,例如星際檔案系統(IPFS)或分散式版本控制系統 Git,採用了後者的方法,使用從內容本身唯一計算出來的 ID(使用雜湊函數)。因為內容 ID 應該始終返回相同的內容,而該內容又可以用來重新計算 ID,所以驗證資料的完整性就變得微不足道。
此時,你可能會問自己,如果內容定址儲存是不可變的,那我們能用它做什麼有用的事嗎?畢竟,我們在現實世界中使用資料代表的事物——你的銀行帳戶餘額、你的好友列表、你的待辦事項清單——都會隨時間而變化。我們如何使用不可變資料作為核心構件來表示隨時間變化的概念?這就是區塊鏈派上用場的地方。
區塊鏈
區塊鏈的核心是一個僅限附加(append-only)的不可變值資料結構——一個區塊鏈條。雖然每個區塊都是不可變且不變的,但我們可以透過讓變數(如帳戶餘額或智慧合約狀態)在不同區塊之間具有不同的值來模擬可變性。從這種模式中,我們免費獲得了可審計性,這意味著我們可以看到任何變數如何隨時間變化,從而允許外部程序直接且有信心地依賴這些資料。
具有智慧合約能力的區塊鏈(如以太坊)還為我們提供了一種編碼資料修改方式及其權限的方法,且這種方式是安全的——這通常是中心化 API 的職責。
這兩項創新開啟了一個新的範式,儲存在區塊鏈和內容定址網路上的資料充當了互通層:
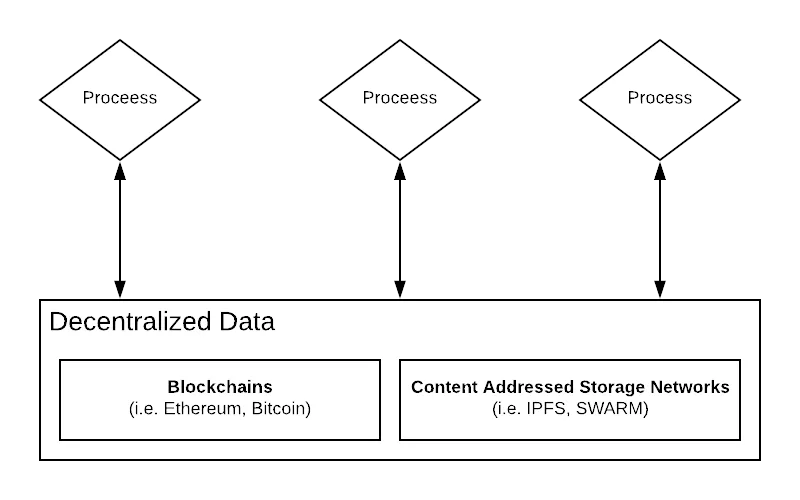
去中心化資料作為互通層
由於區塊鏈被設計為去中心化、無須許可且在對抗性環境中運行,因此不需要將其隱藏在某些額外的保護層之後才能確保安全與穩健。對於儲存在區塊鏈或內容定址儲存網路中的資料,專有 API 不再是架構上的必需品——程序可以直接與去中心化資料互動,將其作為共享的互通基底。
查詢去中心化資料
如果區塊鏈是一種新型的資料庫原語,那我們將如何查詢這些資料?是透過 RESTful API、RPC 調用,還是 SQL 介面?答案必然是以上皆有,但對於旨在基於區塊鏈提供消費級性能的去中心化應用程式(DApps)來說,GraphQL 是自然之選。
GraphQL 比 REST 或 RPC API 更高效
GraphQL 既是一種查詢語言,也是一種介面定義語言(IDL),由 Facebook 發明並開源。它的設計目的是克服我們之前在本文中討論過的傳統 RESTful API 的僵化和低效。它透過直接向 API 消費者公開一種強大且符合使用習慣的查詢語言來實現這一點。
在傳統的 REST(具像狀態傳輸)API 中,每個實體或資源都有一個單獨的端點,定義了你將接收到的關於該實體的資料。例如,要獲取使用者所屬組織的名稱,你可能必須先調用:
/api/v2/users/1
然後再調用:
/api/v2/organizations/7
建立在傳統 API 上的真實應用程式可能會進行數十次或數百次來回網路調用。而且,這不僅僅是 REST 的問題。AdChain 是一個受歡迎的去中心化應用程式,它建立在以太坊 RPC API 之上,被迫向 Infura 進行數百次來回網路調用以載入其 UI,導致網路擁塞和載入時間不理想。
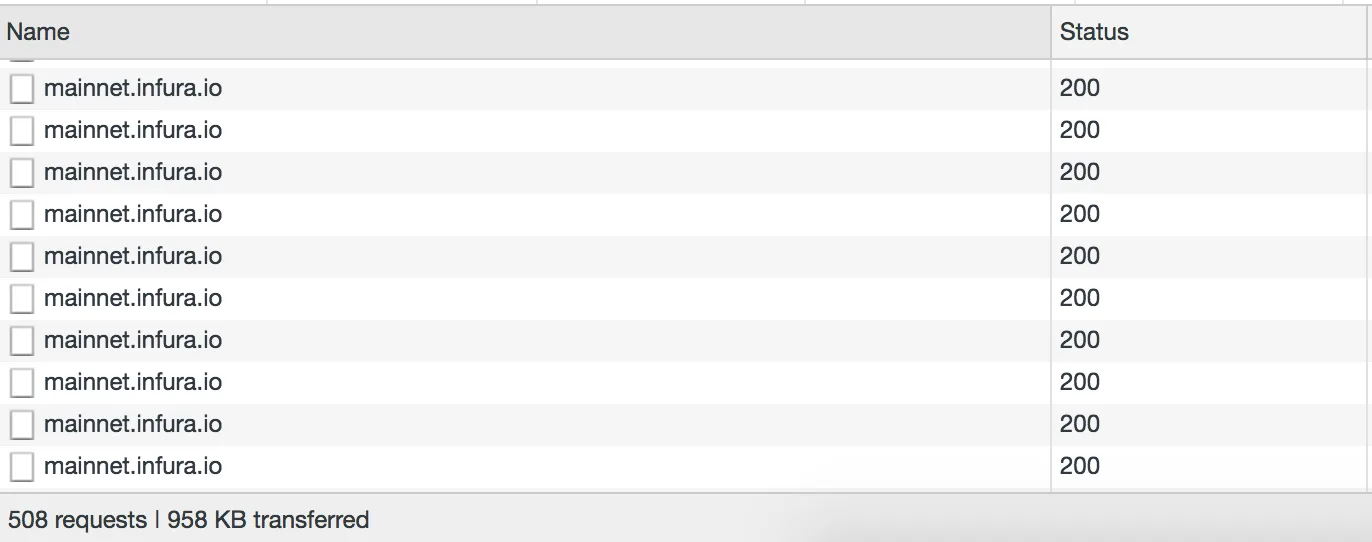
截至撰寫本文時,AdChain 註冊表向 Infura 發出的數百次網路調用:https://publisher.adchain.com/domains
另一方面,GraphQL 足以強大到在單個查詢中表達應用程式所需的所有資料。無論你需要多少資料,使用 GraphQL,你永遠不需要進行超過一次的網路調用。這有時被稱為解決了「擷取不足(under-fetching)」問題。此外,你只會得到你要求的資料,而不多給,從而解決了「過度擷取(over-fetching)」問題。
其結果是,介面對於它們被消耗的方式不再有那麼強的主觀性,只給你想要的資料,並且不需要為了支援外部開發者的新使用案例而不斷更新。
GraphQL 對去中心化應用程式而言優於 SQL
但是,為什麼不像某些人呼籲的那樣,使用另一種查詢語言(如 SQL)來查詢資料區塊鏈呢?
明確地說,我認為這可以而且應該發生。SQL 在全球範圍內被廣泛採用,為數百萬開發者所熟悉,並且作為一種查詢語言,它嚴格來說比 GraphQL 更強大。對於可能不熟悉 GraphQL 的資料科學家和資料工程師來說,它尤其親切。儘管如此,對於構建在區塊鏈上的去中心化應用程式(dApps)來說,SQL 不會是首選語言。
GraphQL 將在區塊鏈 dApps 中勝過 SQL 的幾個主要原因:
- GraphQL 已經「足夠強大」
- GraphQL 對前端開發者來說更符合使用習慣
- GraphQL 的設計初衷就是跨組織信任邊界的數據消耗
讓我們深入探討。
1. GraphQL 已經「足夠強大」
儘管 GraphQL 查詢語言原生不像 SQL 那樣具有表現力,但一個設計良好的 GraphQL 端點可以提供你期望從 SQL 查詢介面中獲得的大部分查詢功能。例如,GraphQL 規範原生沒有指定執行聚合(aggregations)的方法,但像 OpenCRUD 這樣的標準已經出現,規定了如何公開此功能。
仍然有一些長尾功能(如跨實體的即時連接 ad-hoc joins)可能永遠超出了 GraphQL API 的範圍。然而,我估計對於前端應用程式所需的 99.9% 的使用案例,GraphQL 已經足夠好了。
2. GraphQL 對前端開發者來說更符合使用習慣
雖然在功能強度上做出了一點讓步,但 GraphQL 換來的是極佳的使用體驗。例如,GraphQL 具有熟悉的類 JSON 語法:
   query {
   user(id:1) {
   name
   organization {
   name
    }
   }
   }
而且,GraphQL 查詢的響應是一個完全鏡像請求形狀的 JSON 物件。
{
"user": {
"name": "Vitalik",
"organization": {
"name": "Ethereum Foundation"
}
}
鑑於 JSON 是網路上最常用的傳輸資料格式,這種語法對於大多數網頁開發者來說非常易於上手。
與此同時,等效的 SQL 查詢看起來會像:
SELECT user.name, organization.name
FROM user JOIN organization ON (user.organization_id=organization.id)
WHERE user.id=1
雖然看起來不差,但可以說它不如 GraphQL 查詢直觀。
而且,響應資料將會是反正規化且表格狀的,透過你恰好使用的特定 SQL 資料庫的專有傳輸協議發送。相比之下,GraphQL 的響應是直觀的嵌套結構,表現為透過 HTTP 發送的純文字 JSON。
GraphQL 生態系統還有如 React-Apollo 之類的工具,使得將透過 GraphQL 獲取的資料直接整合到網頁應用程式的 UI 組件中變得極其簡單。由於 SQL 幾乎從不直接從行動或網頁應用程式透過 HTTP 消耗,據我所知,SQL 生態系統中不存在此類工具。
3. GraphQL 的設計初衷就是跨信任邊界消耗
或許更重要的是,SQL 端點從未被設計為跨組織信任邊界消耗。例如,如果我們使用 SQL 來提供唯讀的區塊鏈資料,一個過於複雜的 SQL 查詢就足以讓你的資料庫陷入停滯,使其對其他人不可用。
GraphQL 雖然也強大到足以在你的後端觸發任意昂貴的計算,但與 SQL 不同,解決這個問題從第一天起就是焦點領域,並且已有越來越多的研究與工具支援動態阻擋昂貴查詢並對客戶端進行限流(throttling)。
與此同時,SQL 中解決此問題的模擬方法傳統上是手動查找慢查詢並直接重寫它們。或者,可能會添加索引或更改資料庫綱要(schema)以減輕「核准的」昂貴查詢帶來的影響。這就是 SQL 一直以來在組織中的部署性質,只有受嚴格控制的一組人員或服務才能直接查詢端點。
GraphQL 跨組織基因閃耀的另一個地方是其綱要內省(schema introspection)。GraphQL 將綱要內省視為語言的一等公民。
例如,GraphQL 中的 Root 類型有一個 _schema 欄位,可用於內省可用於查詢的類型:
// GraphQL request
query {
**schema {
types {
name
description
fields {
name
}
}
}
}// JSON response
{
"data": {
"**schema": {
"types": [
{
"name": "Root",
"description": null
},
{
"name": "User",
"description": "A user of the platform."
"fields": [
{ "name": "name" },
{ "name": "id" }
]
},
{
"name": "Organization",
"description": "An organization of the platform."
"fields": [
{ "name": "name" },
{ "name": "id" }
]
}
 ]
}
 }
}
公平地對待 SQL,雖然某些內省查詢看起來確實很嚇人,但如果你熟悉語法,與上述內容基本類比的內省看起來也不算太糟:
SELECT c.table_schema,c.table_name,c.column_name,pgd.description
FROM pg_catalog.pg_description pgd
RIGHT JOIN information_schema.columns c on
(pgd.objsubid=c.ordinal_position)
WHERE c.table_schema NOT IN ('pg_catalog', 'information_schema');
然而,這個 SQL 查詢充滿了針對 Postgres 資料庫的供應商特定參數。針對 MySQL 資料庫的等效查詢則會有所不同。此外,雖然上述查詢作為純文字很容易閱讀,但發送該查詢並接收響應需要特殊的工具——供應商特定的 CLI 客戶端或跨供應商的桌面 GUI,後者需理解供應商特定的 SQL 變體、傳輸協議、ODBC 或上述內容的某種組合。
另一方面,GraphQL 對於所有查詢(包括內省查詢)都透過 HTTP 返回純文字 JSON,因此你可以使用 Postman、Chrome 開發者工具或每台 Mac 和 Linux OS 終端機預載的簡單 curl 指令來測試端點。
結論
的確,我強調的 REST 和 SQL 的許多缺點並非無藥可救。人們一直在努力解決 RESTful API 的過度擷取和擷取不足問題。也有人努力為 RESTful API 添加綱要,理論上可以從預定義的端點提供。SQL 也只是一門查詢語言,而非一種實現,因此,沒有什麼能阻止我們建立一個使用 HTTP、透過網路返回純文字 CSV 或 JSON,並具有更合理內省能力的 SQL 介面。然而,像區塊鏈和內容定址儲存網路現在所賦能的那樣,跨組織信任邊界高效地直接查詢任意資料,根本就不在這兩種技術的基因中。
與此同時,GraphQL 從一開始就是為這種使用案例設計的。它在設計時就考慮到了前端工程師,擁有用於高級內省的使用者友善 GUI,以及成熟的工具鏈,使得將 GraphQL 查詢聲明式地綁定到瀏覽器中的 UI 組件幾乎無縫銜接。在 dApps 主要由與運行在區塊鏈上的智慧合約互動的瀏覽器應用組成的範式中,前端工程師的需求和偏好將成為決定去中心化網路技術堆棧的驅動力。這就是為什麼我們已經看到多種努力在為以太坊的 JSON RPC API 加上 GraphQL 介面。
在 The Graph,我們相信在區塊鏈之上構建具有消費級性能的豐富用戶體驗,是實現區塊鏈和去中心化網路大規模普及的主要障礙之一。這就是為什麼我們在去年 7 月開源了一個索引伺服器,允許開發者透過 GraphQL 介面為其去中心化應用程式高效查詢以太坊和 IPFS 資料。未來,隨著區塊鏈上的資料科學和機器學習分析流水線成為更常見的使用案例,我們也將考慮支援 SQL,甚至可能還有其他查詢語言……有人想用 Datalog 嗎?
來源:來自 Medium 的 GraphQL Will Power the Decentralized Web
本頁涉及
術語
-
GraphQL
一種查詢語言:呼叫方說明自己想要的資料形狀,拿回來的就是那個形狀。它在這裡要緊,是因為 OCAP 用它把鏈上資料變成用一個介面就能問,而不是每條鏈配一個客戶端。