為什麼資料分析對區塊鏈產業很重要?
作者: Riley Shu(ArcBlock 資料工程師)
人們可能不會直覺地將「區塊鏈」與「資料分析」聯繫起來。為什麼像 ArcBlock 這樣的區塊鏈新創公司需要資料分析?他們有什麼樣的資料需要分析?今天,我們將分享對鏈上資料分析價值的看法,並一窺 ArcBlock 的資料管線。資料不僅是 ArcBlock 核心產品與服務的一部分,也是我們每項決策的基礎。
什麼是資料?
首先,我們應該統一對資料的定義:資料是一組定性或定量變數的值,源自我們的觀察、實驗或計算。一般而言,資料是人類留下的軌跡,其中包含其行為與活動的詳細資訊。收集並分析資料,讓我們能夠提出從未有人問過的問題,也能找出這些問題的答案。目前,ArcBlock 使用三類資料:鏈上資料、產品資料和系統日誌。
在 ArcBlock,資料分析也涵蓋三個部分:
- 鏈上資料分析
- 產品與使用者資料分析
- 安全稽核
鏈上資料分析
不可變性是區塊鏈的核心特性之一,這表示交易一旦記錄在鏈上,就無法修改或復原。區塊鏈就像一本人人都能查看的公開交易帳本——只要有地址,就能存取該地址參與過的所有交易的完整歷史記錄。
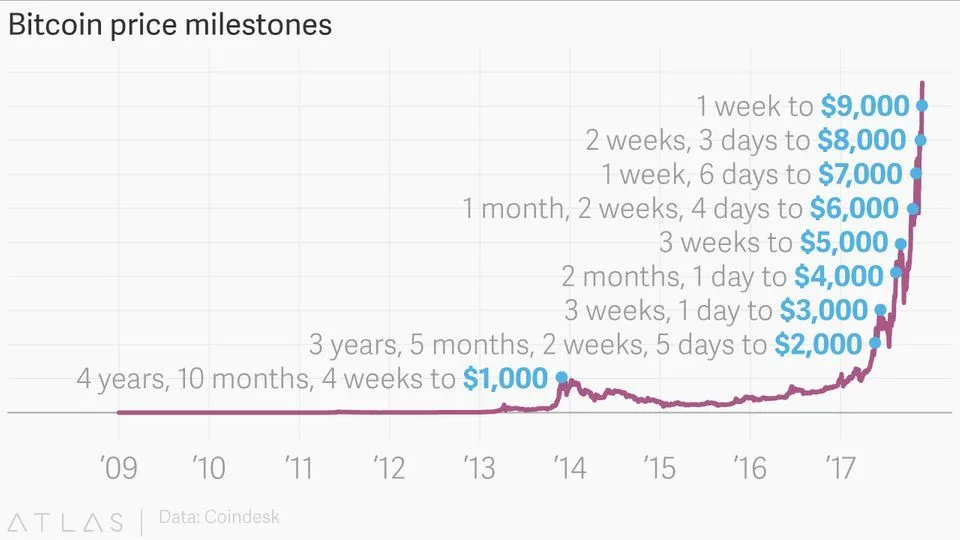
自 2017 年以來,比特幣價格一路攀升,吸引越來越多人將它用作交易平台,並探索區塊鏈的其他可能性。日益增長的興趣豐富了比特幣資料的類型和內容。從 2009 年至今,比特幣已儲存約 17 億筆交易。
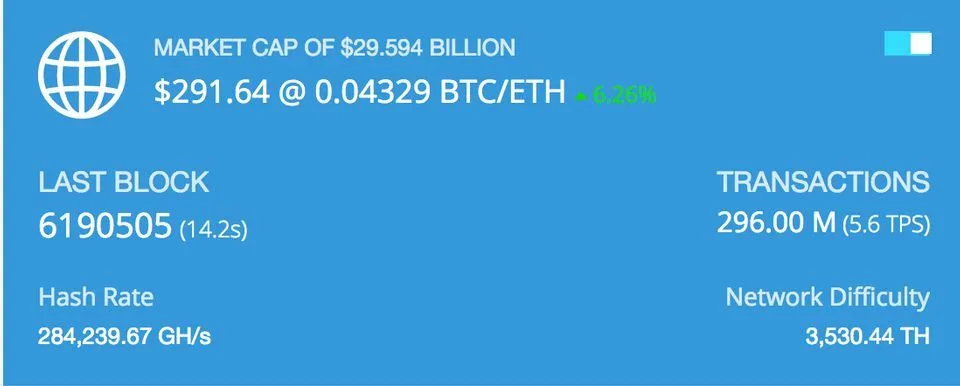
即使是 2015 年誕生、較為年輕的以太坊,也已儲存超過 600 萬個區塊,而且每隔 12 秒,就會產生一個帶有寶貴資料的新區塊。
這些資料代表使用者的金融行為,蘊含大量資訊。我們可以提出許多有趣的問題。資金從哪裡來?流向哪裡?完整的資金流向是什麼?哪個地址存在異常行為?
為什麼市場沒有充斥著針對這些公開資料的分析報告?一種解釋是,由於區塊鏈是去中心化的,公眾沒有足夠的動機製作這類報告;另一個原因則是,分析區塊鏈資料需要具備一定程度的複雜資料結構與演算法知識,這可能讓想開始深入研究資料的人望而卻步。
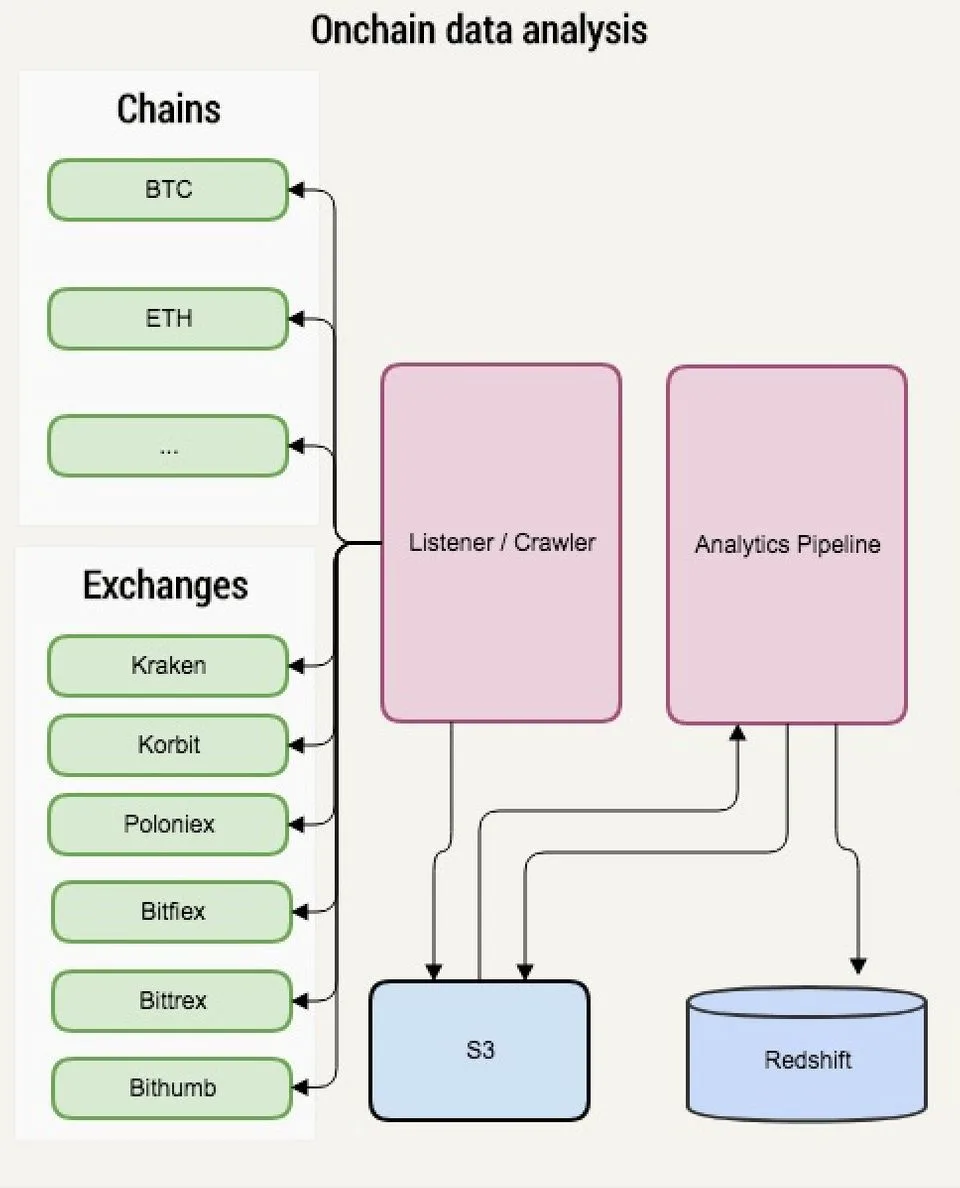
為了更妥善地分析資料,我們已為比特幣與以太坊的資料建立索引,並啟動即時資料監聽器,讓資料維持最新狀態。在先前的文章中,我們介紹過如何為鏈上資料建立索引。在資料處理方面,我們使用 AWS Kinesis 將資料以 parquet 格式串流傳輸並儲存在 S3 上。同時,資料也會輸入我們的資料管線,在其中使用 Apache Spark 執行清理與彙總,再將彙總後的資料傳送到 Redshift,以供進一步查詢與視覺化。
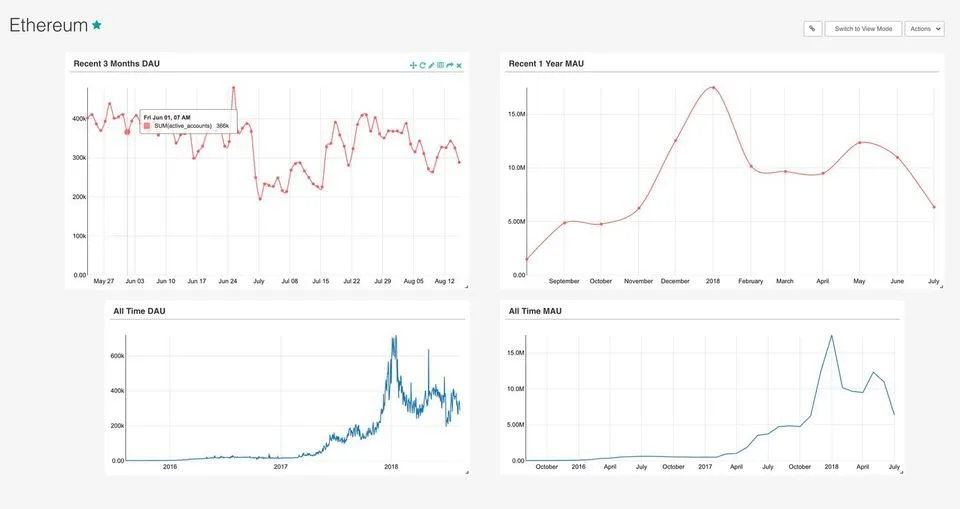
目前,我們正使用 Apache Superset 將以太坊的 DAU(每日活躍使用者)和 MAU(每月活躍使用者)視覺化。未來,我們會在鏈上資料分析中加入更多視覺化內容,例如使用者留存率和冷錢包數量。
產品與使用者資料分析
提供更好服務的關鍵是了解使用者。在產品開發過程中,必須做出許多決策,例如應優先開發哪項新功能,以及什麼樣的網站版面能提供最佳使用者體驗。我們越了解使用者,就越有可能做出正確決策來解決他們的問題。在 ArcBlock,每個決策過程都應該可以追溯,因此我們有信心地使用資料作為指引,因為資料反映了使用者真正的想法——資料從不說謊。
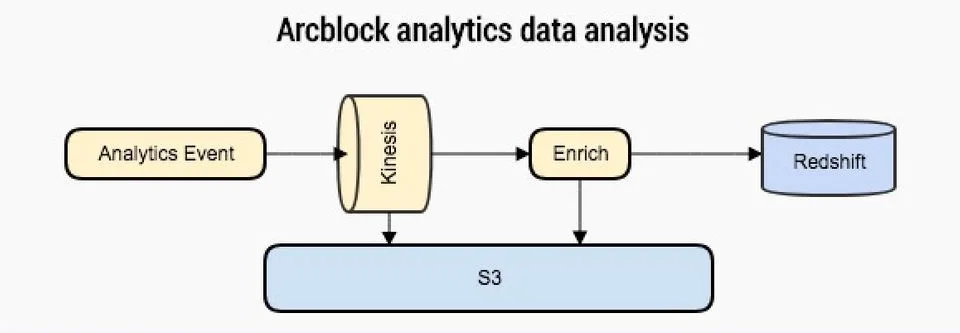
由於資料十分重要,ArcBlock 從一開始就非常重視資料基礎設施。使用者與產品資料管線會擷取即時使用者資料、將資料備份到 S3,並使用 Spark 執行彙總。計算完成後,管線會將資料傳送到 Redshift,以便進行後續分析工作。這條管線與鏈上資料管線相似,但隨著我們開發越來越多功能,管線也會持續最佳化。
安全稽核
區塊鏈是建構新一代網路的基礎設施,而安全始終是首要考量。除了審慎設計我們的安全網路基礎設施之外,我們也使用資料分析來偵測使用者的異常行為,並設法在惡意行為造成任何嚴重損害之前加以阻止。
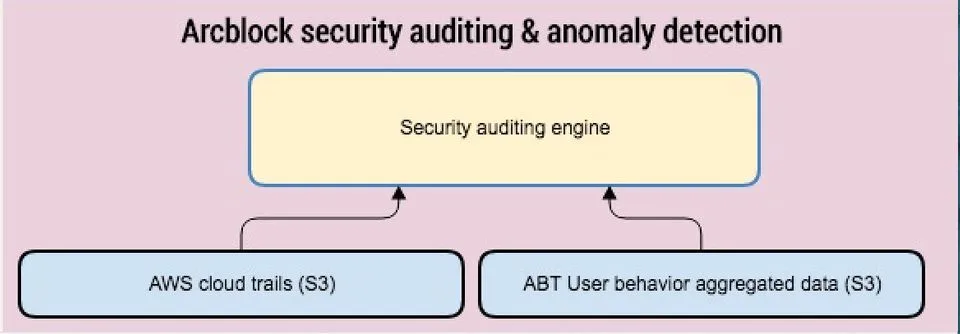
所有系統日誌都儲存在 S3 上。分析引擎會將歷史資料與目前資料進行比較,並使用機器學習模式偵測交易中的異常。一旦發現異常,系統便會向管理員發出警報,並自動暫停可疑操作。
今天,我們簡要介紹了 ArcBlock 使用資料的三種方式。當我們談論區塊鏈的過去與未來時,無論是既有問題,還是尚未提出的問題,資料總是蘊含答案。我們要做的,就是收集所需資訊並揭示真相。
本頁涉及
產品
-
OCAP
active
一個用統一介面查詢鏈上資料的協定,不必每條鏈配一個客戶端。ArcBlock 持有相關專利。