像 SQLite 一样内嵌,像区块链一样可验证:Blockchain、Verifiable Ledger 与内嵌于每个 ARC 的可验证账本内核
过去十几年里,软件工程界在对待「数据可验证性」这件事上,一直陷在一种非黑即白的极端二选一里:
如果一个应用只需要高性能的本地读写,开发者会毫不犹豫地打开一个 SQLite 文件或 PostgreSQL 数据库。它极快、零配置、随进程启动,但它没有任何密码学意义上的历史防篡改能力。只要拿到数据库写权限,管理员、被攻破的后台进程甚至失控的 AI Agent,都可以静默改写过去某条记录的金额、时间戳或授权范围,而不留下任何数学破绽。
反过来,如果一个系统需要不可篡改的审计轨迹与多方对账,传统方案往往要求你「上链」:要么把业务数据塞进一条公开公链,忍受高昂的 Gas 成本、公开内存池的抢跑延迟与全网暴露的隐私痛点;要么自己在机房里拉起一套动辄数十个节点的联盟链集群,还没写一行正经业务代码,先背上沉重的分布式共识运维账单。
我们在演进 ArcBlock 体系与 ARC(Agentic Realm Computer) 的过程中反复追问自己一个问题:为什么「像 SQLite 一样开箱即用」和「像区块链一样数学可验证」,不能是同一件事?
答案是:它们本来就应该是同一件事。只要我们把「区块链」从狭隘的「多节点公链网络」概念中解耦出来,还原它最底层的原子数学内核。
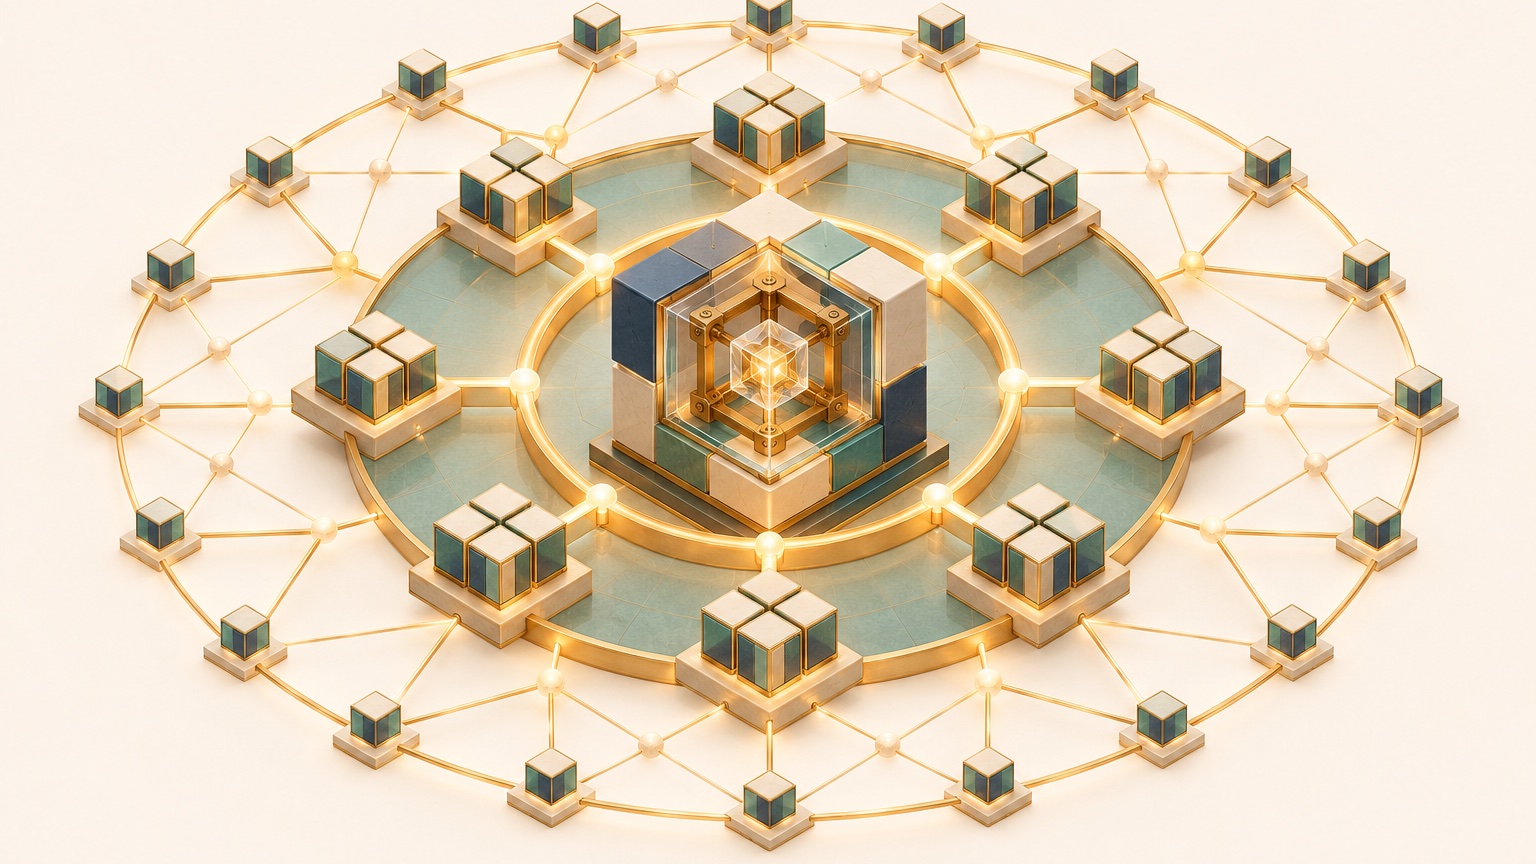
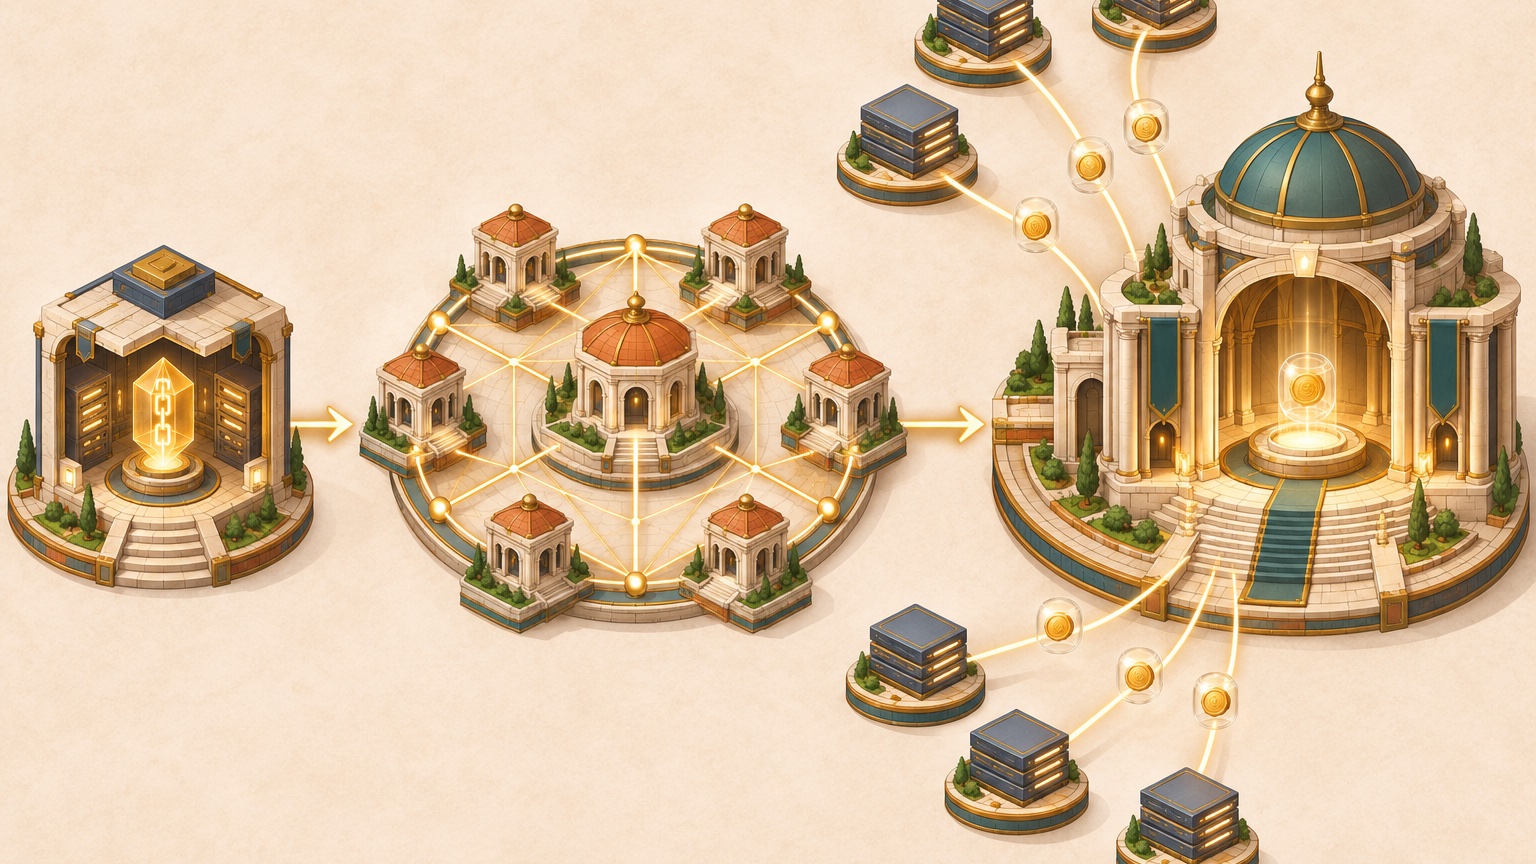
在今天的 ArcBlock 架构中,内嵌于每一个 ARC 的可验证账本内核(Verifiable Ledger Core)、独立运行的可验证账本(Verifiable Ledger),以及跨主体互联的区块链网络(ArcBlock Chain),不再是三套彼此割裂的系统,而是同一颗密码学内核在不同尺度下自然生长出的三层同心圆。
一、第一性原理:区块链的本质不是「公链」,而是可验证日志
当我们把比特币、以太坊以及各类现代账本系统的外围组件一层层剥离,去掉点对点网络广播、去掉挖矿与代币通胀模型、去掉复杂的虚拟机,留在最中心的究竟是什么?
是一条只追加、带签名、由哈希链与 Merkle 树锁死历史顺序的可验证日志(Verifiable Log)。
我们在架构设计中有一个核心公式:
Consensus(Ledger) + Determinism(Algorithm) = Consensus(State)交易或事件的内容本身,已经由发起方的数字签名(Ed25519、Passkey P-256 或后量子 ML-DSA)保证了不可伪造;状态转移的计算过程,只要算法是确定性的,给定相同的输入序列,任何人在任何机器上重放,都必然推演出逐字节一致的状态(State = f(Ledger))。因此,整个系统唯一需要锁定的就是事件发生的先后顺序(Order),以及对这段历史顺序的密码学承诺。
想清楚这一点,架构的边界立刻豁然开朗:
- 可验证性(Verifiability)不需要以多节点网络为前提。哪怕在单机、单进程、单个 AI Agent 容器甚至手机离线环境里,只要事件按哈希链追加、定期由增量 Merkle 树生成带签名的封账检查点(Checkpoint),这份本地历史就是自我证明、防静默篡改的。
- 共识(Consensus)与锚定(Anchoring)是可以按需叠加的外部维度。当账本只在单个 ARC 内部运行时,它由当前实例签名封账;当它扩展到组织与多方协作时,可以叠加独立见证连署(Witness Cosigning);当它需要跨组织公信力时,只需把不到 100 字节的 Checkpoint 摘要锚定到公开主链上。
基于这一判断,我们没有给 ARC 另写一套简陋的「本地审计表」,而是直接从区块链引擎中提炼出了零外部共识依赖、纯确定性的 Verifiable Ledger Core,并将它作为标准基础设施内嵌进每一个 ARC 实例。
二、内嵌于每一个 ARC 的 Verifiable Ledger Core
在 ARC 的运行时架构中,文件系统(AFS)是一切状态与能力的统一抽象接口。而 vledger:// 正是每一个 ARC 原生内置的核心安全 Provider。
无论一个 ARC 实例是跑在开发者的 MacBook 命令行里(基于本地 SQLite)、部署在企业的私有服务器上,还是运行在 Cloudflare Workers 的边缘节点(基于 Durable Objects SQLite 或 D1)中,它都不需要连接任何外部区块链节点,就能在本地直接挂载并驱动一颗完整的 Verifiable Ledger Core。
1. 哈希链、增量 Merkle 树与签名检查点(Checkpoint)
当 ARC 内部的应用、工作流或 AI Agent 产生一笔关键操作(例如权限变更、预算扣减、凭证签发或外部接口调用)时,EmbeddedLedger 会按严格的确定性流水线将事件写入账本:
Event Input (from, type, payload, nonce, timestamp)
  │
  ├─► 1. Canonical Serialization (确定性键序序列化 → txRaw / txHash)
  ├─► 2. Hash Chain Linking: sha256(prevHash : sequence : msg)
  ├─► 3. Deterministic Entry Hash: computeEntryHash(sequence, txRaw, stateCommitHash)
  └─► 4. Window Sealing (如每 100 条):
IncrementalMerkleTree → txRoot + stateRoot → Signed Checkpoint- 确定性条目哈希(
entryHash):每一条写入账本的记录不仅包含递增序号sequence与原始事件载荷txRaw,还绑定了执行后的确定性状态承诺stateCommitHash。任何对历史事件内容、执行成败状态或顺序的微调,都会导致后续整条哈希链断裂。 - 增量 Merkle 树与封账检查点(
Checkpoint):每达到设定窗口(例如 100 条记录或定时触发),内核会构建覆盖该窗口的 Merkle 树,产出交易根txRoot、状态根stateRoot以及指向上一封账点的prevCheckpointHash,并由当前账本提案者(Proposer)签名落盘。 - 亚毫秒级包含性证明(Inclusion Proof):验证某条记录是否真实存在于某个已签名的历史窗口中,不需要扫描全表。通过窗口级 Merkle 树缓存与单飞(Single-flight)构建机制,生成一次包含性证明仅需约
1.7ms,而在客户端或对端验证这份证明仅需0.03ms ~ 0.08ms。
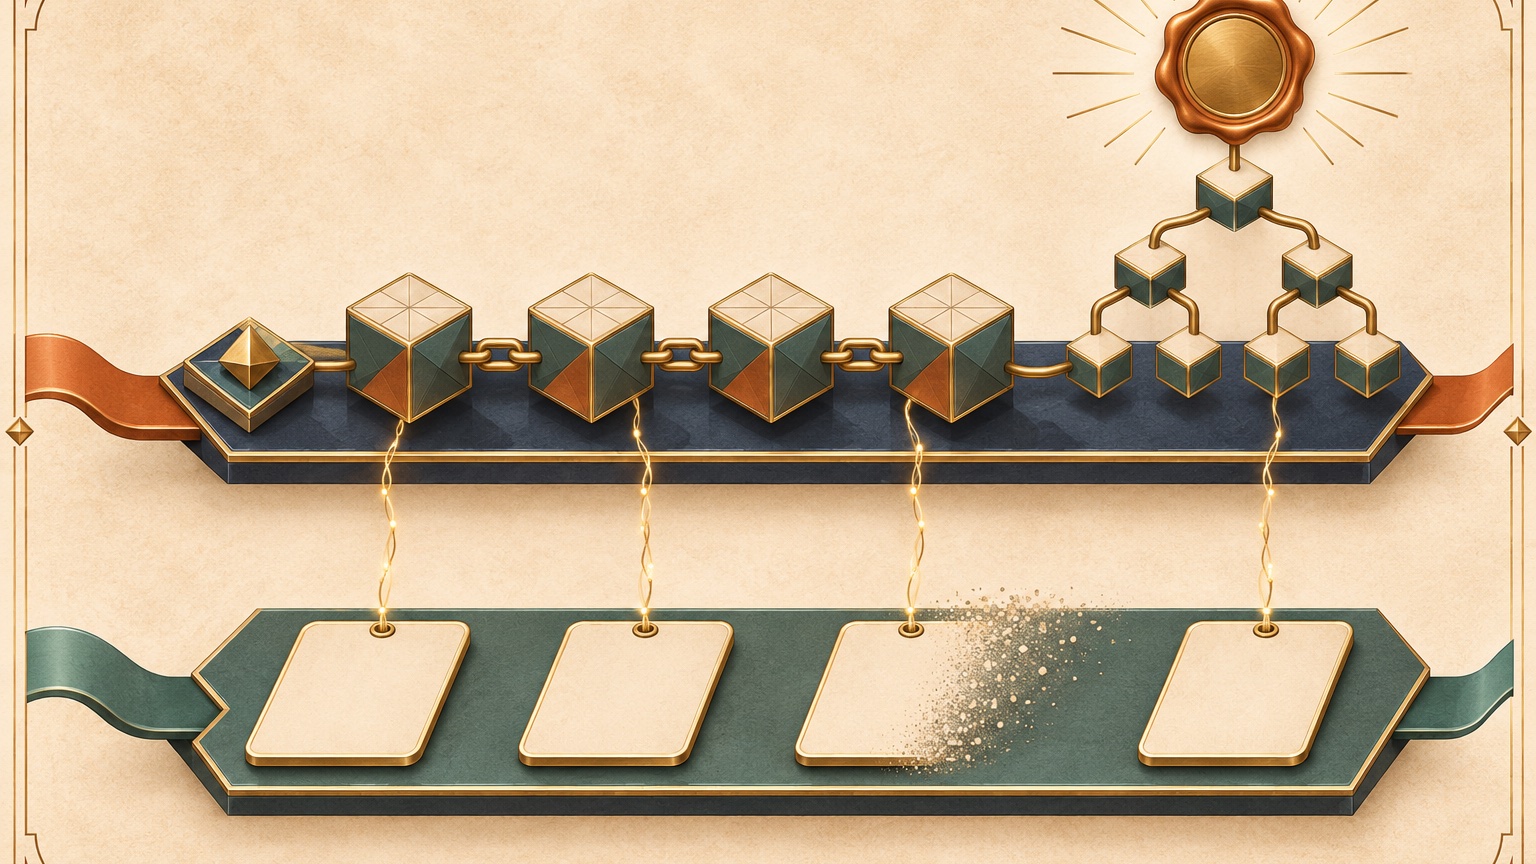
2. Fact 与 Content 分离:只追加账本如何兼顾隐私与合规擦除?
很多工程团队不敢在业务系统里引入只追加(Append-only)账本,最大的顾虑是隐私合规(例如 GDPR 的「被遗忘权 / Right to Erasure」):如果所有记录永远不能删改,用户的姓名、邮箱或敏感业务文档岂不是一旦写入就永远无法擦除?
在 Verifiable Ledger Core 中,我们从一开始就确立了 Fact(可验证事实)与 Content(可变内容原文)分离 的设计原则:
| 记录类型 | 写入 Ledger(不可篡改层)的内容 | 写入 State(可更新/可擦除层)的内容 | 删除/脱敏后的验证效果 |
|---|---|---|---|
| 纯事实型事件(Fact-only) (如转账、额度扣减、投票、授权开关) | 完整事件记录(from / to / amount / action 本身即不可分割的系统事实,不含个人敏感隐私) | 推演后的当前余额、配额或权限视图 | 事实永久保留,状态随时可由账本100%重放重建 |
| 附带文档型事件(Fact + Content) (如 DID 文档注册、含隐私声明的凭证、业务单据) | 仅记录事实骨架 + 内容哈希(例如 did + timestamp + contentHash) | 完整的文档原文(支持后续更新、加密或合规物理删除) | 原始内容存在时,校验 hash(content) == contentHash 证明未被篡改;原始内容被合规擦除后,哈希链与历史封账依然 100% 完好可验证 |
换句话说,「账本只追加」绝不等于「所有业务文本都不能擦除」。当用户行使删除权时,系统只需从状态层抹去文档原文;账本上的 contentHash 无法逆向还原出任何隐私信息,却依然能在数学上证明「该主体确实在某年某月某日完成过这次注册,且前后的历史账目从未被人事后抽页或伪造」。
3. 原生 AFS 暴露与 AI Agent 预算闸门
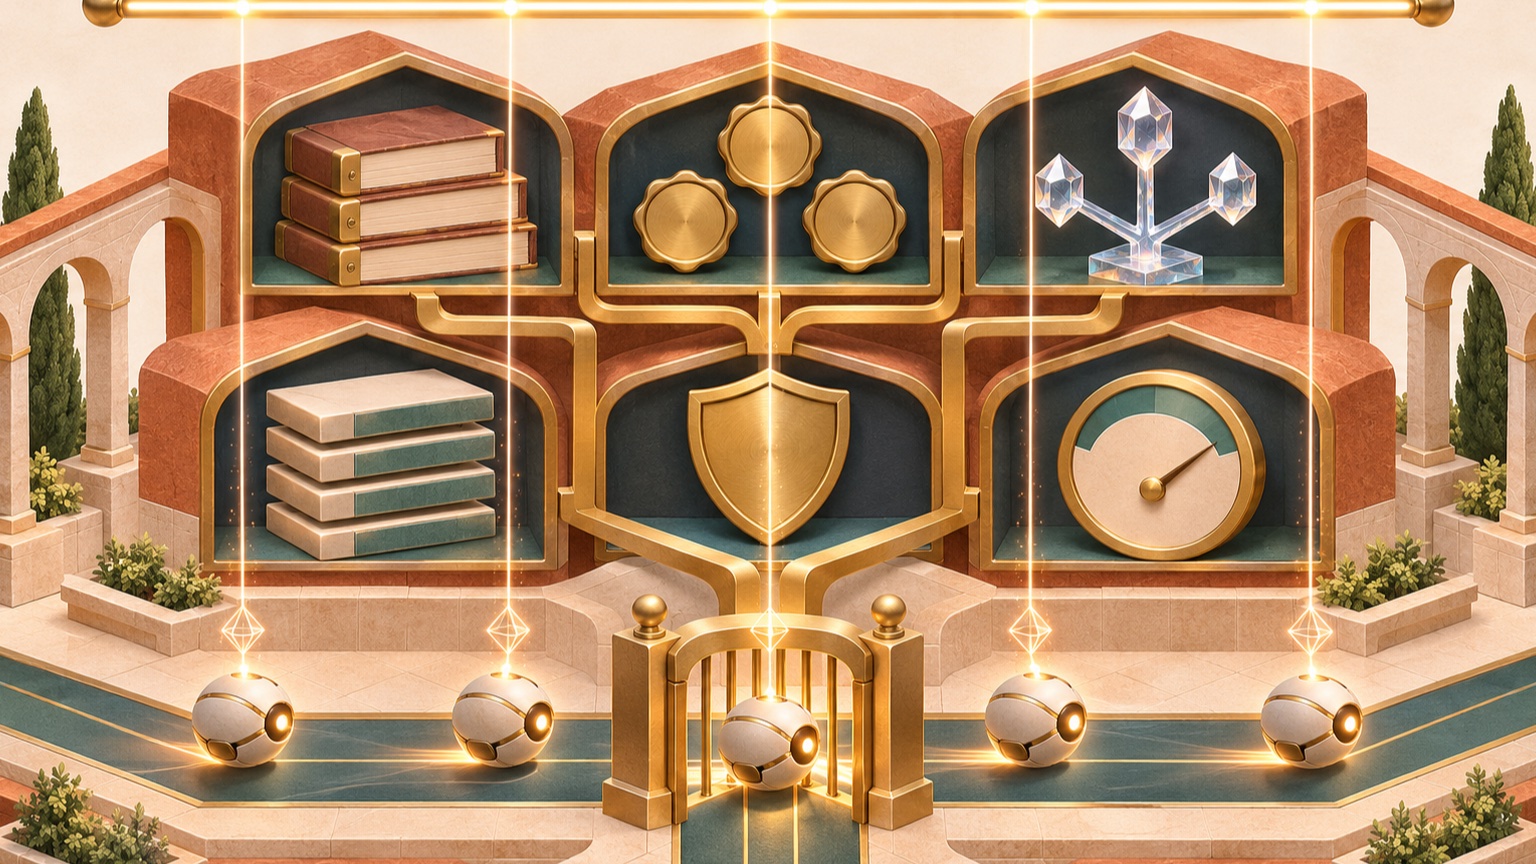
因为 Verifiable Ledger Core 直接通过 vledger:// 挂载在 ARC 的文件系统树上,任何具备相应权限的模块或 Agent 都不需要学习复杂的区块链 SDK,直接通过标准的 AFS 路径就能读写和校验账本:
/entries与/checkpoints:读取按序号排列的不可篡改事件流与签名封账点;/proofs与/segments:按序号获取单条记录的 Merkle 包含性证明,或导出冷热分层的压缩历史切片(Segment)用于归档;/policy与/consumption:内核原生内置的支出策略与配额计量引擎。
举一个在 AI Agent 时代极其现实的场景:假设你的企业部署了 50 个自主运行的 AI Agent,分别负责代码审查、客户支持、外部 API 采购与云资源调度。到了月底,财务发现总账单超支了 50%。如果这些 Agent 的调用记录只写在普通的应用日志里,IT 团队往往要耗费数天去拼凑散落在各处的日志,甚至分不清究竟是哪个 Agent 的哪次委托授权越了界。
而在内嵌了 Verifiable Ledger Core 的 ARC 中,每个 Agent 的单笔限额、日度/月度预算(Budget Quota)以及委托作用域(Delegate Scope)都受控于 /policy,每一次消耗都作为带签名的可验证事实追加进 /consumption 并生成 Merkle 检查点。合规审计与成本溯源,从此不再是一场浩大的取证工程,而是一次毫秒级的可验证查询操作。
三、从内嵌内核到独立主权账本(Verifiable Ledger)
当我们将视野从单个 ARC 内部放大到一个完整的应用系统、一家企业或一个 AI Agent 集群时,同一颗 Verifiable Ledger Core 就直接生长为第二层形态:独立主权的可验证账本(Verifiable Ledger,简称 VLedger)。
在架构实现上,我们的引擎原生支持「链网双运行模式(Dual Operating Modes)」:即公网主干链模式(Chain Mode)与轻量级主权账本模式(Ledger Mode)。
对于绝大多数企业内部审计、部门间结算、供应链流转或专属应用状态机而言,根本不需要发币、不需要复杂的 Gas 竞价,也不需要让外部匿名矿工来参与共识。开启 Ledger Mode 后,系统具备以下工程特性:
- 零 Gas 预设与纯 DID 签名准入(Tokenless Preset):无需预先铸造代币或配置复杂的手续费金库,业务参与方直接凭各自的 DID 签名与委托授权即可向账本写入可验证事件。
- 用「几 KB 的 Checkpoint 增量流式备份」替代脆弱的数据库主从复制:
传统高可用架构为了防丢数据,往往要维护沉重的数据库主从同步(Master-Slave Replication)。而在三库分离与确定性状态推演(
State = f(Ledger))的保障下,主权账本每封口一个 Checkpoint(例如每 100 笔事件),只需将几 KB 大小的增量切片{ checkpoint, entries }流式备份到 DID Space、S3、R2 或本地 NAS。一旦发生机器损毁,新实例只需拉取单份Ledger切片重放,就能 100% 确定性地重建出完整的State DB与Index DB,并在恢复过程中自动逐块校验签名、txRoot与stateRoot,任何云端存储层面的静默比特翻转或恶意篡改都会在恢复瞬间被当场捕获。 - 受启发于现代银行业的「Checkpoint + Reconcile(封账与日终对账)」哲学:
为什么现代银行不用全网算力挖矿,依然能管理全球数百万亿的资金?因为金融工程的可靠性从来不是建立在「假设软件永远不出错」的空想上,而是建立在「每一笔账都有据可查、定期封账对账(Reconcile)、一旦出现差错可立即发现、可定位、可追责并按规则冲正」的机制之上。
Verifiable Ledger将这套成熟的金融对账哲学带入了数字世界。
四、生长为可验证账本网络:VLedger Anchor 与主链的真正角色
既然每个 ARC、每个应用、每家企业都可以拥有自己极速、私密、零成本的 Verifiable Ledger,那我们为什么还需要 ArcBlock Chain 主链?
这正是三层同心圆最精妙的闭合之处:我们构建的不是一条试图包揽全人类所有计算的孤立单链,而是一张由无数个可验证账本彼此锚定、按需互联的「可验证账本网络(Network of Verifiable Ledgers)」。
1. 为什么企业与 AI Agent 需要跨层级锚定(Anchor)?
一个完全运行在企业本地服务器上的 Verifiable Ledger,虽然能防住外部黑客和普通内部人员的篡改,但面对外部审计机构或跨组织合作方时,仍有一个终极信任问题:如果企业最高管理员把本地整个账本数据库删掉,用自己的私钥从头重签一份伪造的历史账本,外部人员如何识破?
答案就是 Checkpoint Anchor(检查点锚定)。
应用内嵌账本或企业级 Verifiable Ledger 可以按需(例如每小时、每天,或在重大合同签署后),将最新 Checkpoint 的核心摘要打包成一笔极简的 AnchorTx 发布到更高层级的组织链或 ArcBlock Chain 主链上:
message AnchorTx {
  bytes  source_id         = 1; // 来源 Verifiable Ledger 的 DID
  uint64 checkpoint_height = 2; // 封账高度
  bytes  merkle_root       = 3; // 32 字节 Merkle Root (涵盖 txRoot 与 stateRoot)
  uint64 event_count       = 4; // 窗口内事件数量
  bytes  metadata          = 5; // 可选扩展元数据
}整笔链上锚定交易的体积不到 100 字节。
2. VLedger Anchor 与传统 L2 Rollup 的本质区别
许多熟悉以太坊生态的读者可能会问:这和 Rollup 有什么区别?区别在于数据主权与成本结构:
| 对比维度 | 传统区块链 L2 Rollup | ArcBlock VLedger + Anchor |
|---|---|---|
| 数据存放位置(Data Availability) | 必须将全部压缩交易数据发布到公网 L1 或外部公共 DA 层,否则无法完成安全证明 | 原始业务数据 100% 留在应用/企业本地或私有 DID Space,绝不向公网泄露半点业务明细 |
| 主链承担的职责 | 主链需存储海量 Calldata/Blob 并重算或验证全部状态转换 | 主链只做不可伪造的外部时间戳公证 + 状态存在性与连续性锚点 |
| 单次上链成本与吞吐瓶颈 | 高昂(受限于公共 DA 带宽与 L1 区块空间) | 极低(每次仅 < 100 Bytes 哈希摘要),本地账本吞吐不受主链任何限制 |
| 审计验证方式 | 全网公开透明,无商业机密可言 | 选择性披露(Selective Disclosure):仅向授权审计方或交易对手出示本地账本片段与 Merkle 包含证明,对照主链锚点即可完成零信任核验 |
一旦某次 Checkpoint 的哈希被锚定到主链上,哪怕是拥有最高权限的服务器管理员,也再也不可能在不被发现的情况下重签或回滚那个时间点之前的任何一条本地记录。因为全网公开的锚点已经像钢印一样,把「在某个确切时刻,这份账本的 Merkle 根只能是这个值」永久镌刻在了公共时间线上。
五、结语:Anyone Can Verify. Nobody Has To.
回顾这套从内向外层层展开的架构:
- 在最内层,
Verifiable Ledger Core像 SQLite 一样安静地内嵌在每一个 ARC 与每一个终端钱包里,不消耗任何多余的网络开销,却为每一次本地状态变更、每一次 AI Agent 的预算消耗生成严丝合缝的哈希链与增量 Merkle 承诺; - 在中间层,
Verifiable Ledger让任何应用与组织都能以零发币、零复杂运维的方式跑起独立主权的可验证账本,用几 KB 的签名 Checkpoint 切片实现 100% 确定性的灾难恢复与日终对账; - 在最外层,
ArcBlock Chain作为高公信力的公共结算与锚定母网,用不到 100 字节的轻量锚点将成千上万个独立的Verifiable Ledger编织成一张跨主体协作的价值与信任网络。
我们在设计文档里写下过一句全团队非常喜欢的话:「Anyone can verify. Nobody has to.(任何人都能随时验证,但没有任何人被强制背负全网节点的包袱。)」
把区块链从沉重的「节点教条」中解放出来,变成像文件系统和 SQLite 一样无处不在、随手可用的基础内核,这正是我们将 Verifiable Ledger Core 装进每一个 ARC 的初衷。在下一篇文章中,我们将顺着这颗同构内核走进用户的手机与 Agent 终端,看看当钱包本身也成为轻量验证节点、并用完全同构的 Verifiable Ledger 管理本地数据与加密对账批注时,终端安全会发生怎样彻底的蜕变。