ARC 上的 Web 内容系统:不理解你的内容,反而更简单
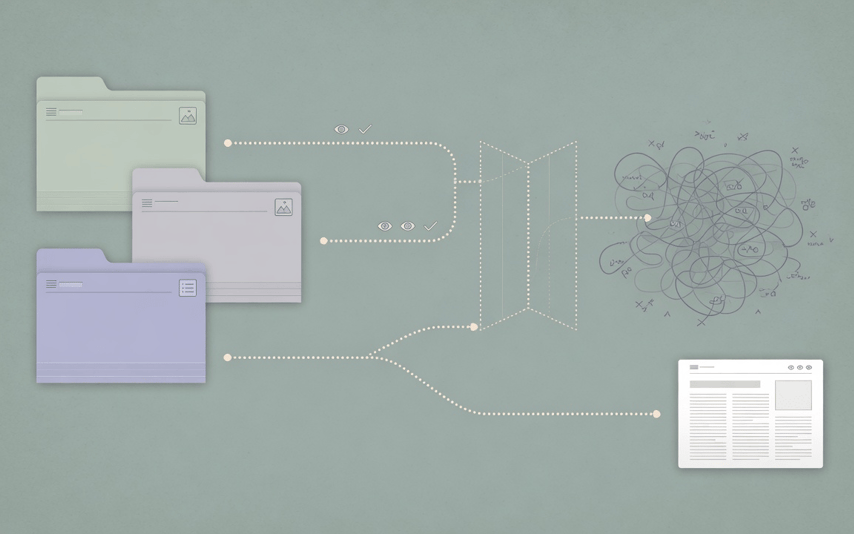
建站系统的复杂度,很大一部分来自它试图理解你的内容。
WordPress 要你注册 post type,Astro 要你在 src/content.config.ts 里定义 collection。它们不是坏例子,恰恰相反:这是两套很成熟、也很有用的做法。站点先把「文章」「产品」「文档」这些类别交给框架,框架就能替它处理路由、校验、查询和编辑体验。[1][2]
我想讨论的不是「配置文件算不算代码」,更不是「目录比 schema 高明」。真正的分界线是:每当一个站点多出一个新名词,运行时是否也必须多出一个内置类型。
这里的「不理解」有很窄的意思:共享运行时不拥有领域名词。它知道怎样读内容、组织页面和渲染界面;它不替每个站点决定什么是产品、活动或术语。语义、校验和查询仍然需要,只是应该放在真正拥有它们的那一层。
这正是 Web Device 想改变的地方。
AFS(Agentic File System)给内容一个文件系统抽象;AUP(Agentic UI Protocol)描述界面;Web Device 则把前两者组织成一个网站。它们都运行在 ARC 上。关于这些名字和基本用法,我在上一篇里已经交代过;这里谈的是它们放在一起之后,内容模型可以放在哪里。
WordPress 和 Astro 的对照,应该怎么读
在 WordPress 里,注册 custom post type 的通常做法是在 init hook 上调用 register_post_type()。类型的名称、URL、能力和查询方式因此成为站点运行时的一部分。[1]
Astro 的 collection 也不是一个普通目录名。它有 loader,也可以有 schema;框架据此提供类型检查、校验、查询和内容 API。[2]
这两种系统各自解决的是一个很真实的问题:怎样让一个站点把内容模型说清楚,并让工具可靠地围绕它工作。它们并不意味着两个站点不能复用同一个「产品」定义,也不意味着每次改内容都要迁数据。把它们写成那样,只是为了把自己的故事讲得轻松一点。
我真正想借它们指出的是另一件事:它们把站点的内容类别放进框架认识的模型里。于是「产品」这个词不只是数据,也是框架要知道的一种东西。
ARC 可以选择另一条分工。Web Device 能发现 content/ 下的目录名,但可路由的 collection 仍要由站点声明;发现目录不是另一套偷偷藏起来的类型系统。即使如此,它也不需要知道 product 在业务上是什么意思。一个对象的资料、它的元数据和它要呈现的界面,可以由数据与声明式界面契约带进来;真正理解「这是一个产品引用」或「这是一个活动状态」的,是相应的应用部件,不是 AFS。
一个目录当然不会自动变成一个产品功能。今天的站点已经有文章和文档;文档甚至有自己的导航行为。如果我们决定做产品、术语表和活动,它们会是接下来的真实检验;它们并不是已经完成的功能。要验证的是:当这些对象出现时,我们能不能不再为每一个新名词给 Web Device 增加一条新的运行时路径。
Web Device 解决的,不是把目录画出来
如果答案只是「把文件放进目录」,根本不需要 Web Device。每个应用自己读文件、拼页面、处理多语言、做导航、做列表、做搜索、做归档,也能得到一个网站;代价是每个站点都要重新学一遍这些功课。
Web Device 的价值在于把这类通用工作做成一层可复用的运行时:它读取经由 AFS 提供的内容,按 AUP 和站点声明组织页面,并把常见的网站结构做成可复用的能力。它不应该替每个站点定义「产品」或「活动」究竟是什么;它应当让真正知道这些含义的部件有地方把它们呈现出来。
分层因此很简单,但不能混着说:
| 层 | 负责什么 | 不负责什么 |
|---|---|---|
| AFS | 提供和移动数据 | 渲染页面、判断业务含义 |
| AUP | 声明界面结构 | 决定业务对象的真实含义 |
| Web Device | 读取内容、组织并渲染网站的通用结构 | 把每个新名词做成运行时内置类型 |
假设我们要增加一个产品对象。Web Device 应只提供通用的集合和详情页机制;站点声明它怎样挂到路由上;产品对象带自己的数据和 schema;产品引用部件决定文章里怎样显示它。这个分工如果成立,AFS 从头到尾都不必知道「产品」这个业务词。
这也解释了为什么「底座不理解语义」不等于「系统没有语义」。一个产品改名后,旧文章里的产品卡片仍应显示新名称;但知道某个字段是产品引用的,应当是产品引用部件或该对象的声明,而不是文件系统。语义没有消失,它被放在真正拥有这层知识的地方。
不把语义塞进底座,换来的是什么
第一个收益是边界更清楚。AFS 不需要知道一篇文章为什么引用一个产品;Web Device 也不需要为每一种引用关系维护一个核心数据模型。站点可以在部件和对象声明中演进自己的语义,而不会轻易把一次站点选择变成所有应用都必须接受的底层规则。
第二个收益是复用可以更诚实地被检验。这还不是已经证明的能力,而是我们应当拿来验收的标准:一个对象目录带着公开的数据和界面声明,放进另一个具备兼容 collection 和标准部件的站点之后,如果没有依赖私有部件,它应该仍然能被理解和呈现。做不到时,不该叫它「通用对象」;它只是某个站点的一段模板。
第三个收益是构建依赖不必猜测业务关系。一次渲染实际读了哪些对象、集合和模板,运行时就可以据此决定哪些输出需要重新生成。这个机制不必理解「合作伙伴」「产品」或「活动」这些名词;但它也不会自动替我们发明关系模型。依赖怎样记录、怎样失效,仍然是 Web Device 的实现责任,不是目录这件事本身保证的。
代价不能藏起来
把内容类别从核心运行时里拿出来,不会把校验和查询变没。
校验需要由对象自己的 schema 或声明承担。查询需要索引。跨对象的引用需要明确的契约。没有这些东西,目录只会变成一堆碰巧能被读到的文件,而不是可维护的内容系统。
这也是我仍然愿意提 HyperCard 的原因。它提供了一个很好的画面:一张 card 可以同时带着资料、外观和行为,作者决定它代表通讯录、导览还是游戏。可是它不是我们要复刻的模板。HyperCard 的 stack 是私有的二进制格式;Apple 没有留下正式规范。美国国会图书馆记录的一份逆向说明也承认,它还不足以可靠地更新或新建 stack。[3]
这里真正值得吸取的不是「把一切塞进卡片」,而是可移植性这件事不能事后补。目录、纯文本和声明式界面没有天然解决语义、校验或查询;它们只是让更多工具能够读取、生成、检查和批量修改这些材料。剩下的契约必须明确写出来。
回到 Web Device
所以 Web Device 不是一个把 AFS 目录直接涂成网页的工具。它是一条分界线:通用的 Web 工作由一个可复用运行时承担,具体对象的含义留给对象数据、声明和部件来表达。
这条边界现在还在接受检验。如果我们选择产品、术语表和活动作为接下来的对象,它们就会是第一批真正的测试:它们要有清楚的 schema、可用的界面、可验证的引用与查询,同时又不要求 Web Device 为每一个新名词长出一块专用运行时代码。做到,说明这套分层有价值;做不到,就该回头承认哪里还把语义放错了层。
这就是 Web Device 真正该提供的东西:复用通用的 Web 工作,让具体对象的含义保持明确且可演进。