Context 不是 cognition
有人把 AFS 问到了它最容易被误读的地方:如果把 agent 周围的信息整理得更清楚,是不是就离 cognition 更近了一步?
我当时的回答很短:
“Very well said — this paper is squarely about context, not cognition.”
(译:说得很好,这篇论文明确讨论的是 context,不是 cognition。)
这仍然是我想保留的边界。这篇论文用文件式抽象讨论 agent context,提出 AFS 这个研究命题;它不是“只要把资料摆好,系统就会更会思考”的说法。我想把这个研究问题展开一点,而不是拿论文去替任何现有产品背书。
Context 不能替代判断
假设一个 agent 正在比较两份政策草案。它眼前的段落、引用来源、刚得到的工具结果和此前留下的笔记,共同构成这一刻的 context。把这些材料的出处、位置和变化讲清楚,是 context engineering 要处理的事。它不能替 agent 判断哪一份政策更合理。
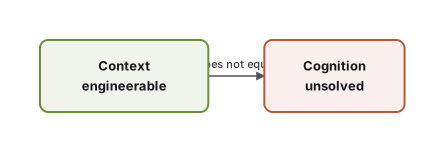
Context can be engineered; cognition is not thereby solved.
系统当然可以按一条规则,把“最新已批准的版本”放到 agent 面前,并留下这次选择的来历。规则执行的是已经给定的标准;判断还包括标准本身是否可靠、例外该怎样处理。前者让 context 有边界,也能被回看;后者不是 AFS 论文声称已经解决的 cognition。
这个区分不只是保守。它把一个容易被口号吞掉的问题拆开了:什么材料应该进入工作过程,为什么是它,后来又怎样被替换或质疑。选择、更新、冲突与责任都还在,但不必再被塞进“模型会自己想明白”这句话里。
我为什么仍然在意这个命题
论文借文件系统谈的,不是把世界缩成一棵目录树,而是给 context 一个可以被组织、讨论和检查的共同表面。至少,我们应该能够追问:眼前这份材料从哪里来,为什么现在出现,之后还能不能回头看。
这不会给系统补上一颗大脑。它只是把原本散落在 prompt、工具调用和临时记录里的条件,变成可以认真研究和工程化处理的对象。对我来说,这已经是一个足够大的问题,不需要借 cognition 来抬高它。