AI 编程 Agent 的降智现象:跨厂商使用记录与初步分析
声明: 本文仅代表我个人的观察与判断,不代表我所在公司的立场。文中关于各工具的使用评价来自我的个人体验,并非受控实验结果;外部研究和报告另行注明出处。
这个星期,我被 Grok Build 的最新版本折腾得很痛苦。干活慢,额度消耗快,原来不用提醒的事情又要反复催。用这些工具是为了开发我们自己的产品,结果我又花了不少精力在盯着工具本身。
我转去试已经开放的 Google Argon 和 Antigravity,一下有了似曾相识的感觉。它做事快,结果也好,能准确理解要求,主动把工作往下推进。可用额度给我的感觉也很充裕,不再总想着还能撑多久。
我以前不是没遇到过这么好用的 Agent。Claude Code 在今年一二月让我很满意;后来 Codex 的严谨性很有价值;再后来 Grok Build 成了主力。只是使用一段时间以后,我又会开始觉得它变慢、变难用,有时是逻辑和指令遵循变差,有时是过度思考。现在熟悉的好感觉回来了,疑问也跟着回来了:为什么这样的过程会在不同厂商的工具上反复出现?
还有一个让我困惑的变化:有些输出越来越难读,越来越“不说人话”。大语言模型最初让我惊讶的,恰恰包括写作能力。为什么编码成绩进步,未必带来更好的沟通和日常开发体验?
下面把我截至 2026 年 10 月 29 日的使用记录、同行反馈、公开复盘和独立测试放到一起。Grok 恰好留下了八月、九月的好评与十月的公开更正,可以提供一组同期样本;Claude 和 Codex 也有各自不同的体验。这还不是统一任务的长期对照实验,但足以让我认真调查这些变化,以及开发者可以怎样应对。
这段经历还有一个背景:大约从 2025 年十二月起,我们团队开始转向 Claude Code;从今年一月起,我个人也高强度地使用不同的 code agent,直接参与产品编码。这里记录的是长期实际开发中的变化。
我们的用法一直是 mix-and-match。通常由一个 Agent 主写,另一个 Agent 做 code review,也持续尝试 agent loop 和自动化软件工程。我之前写过 IDD(Intent Driven Development)、从手工循环到成对 skill 的 loop engineering 实战,以及无人值守的 issue/PR 循环。那些文章记录的是方法怎样使用,这一篇记录的是在这种用法里,工具本身怎样变化。
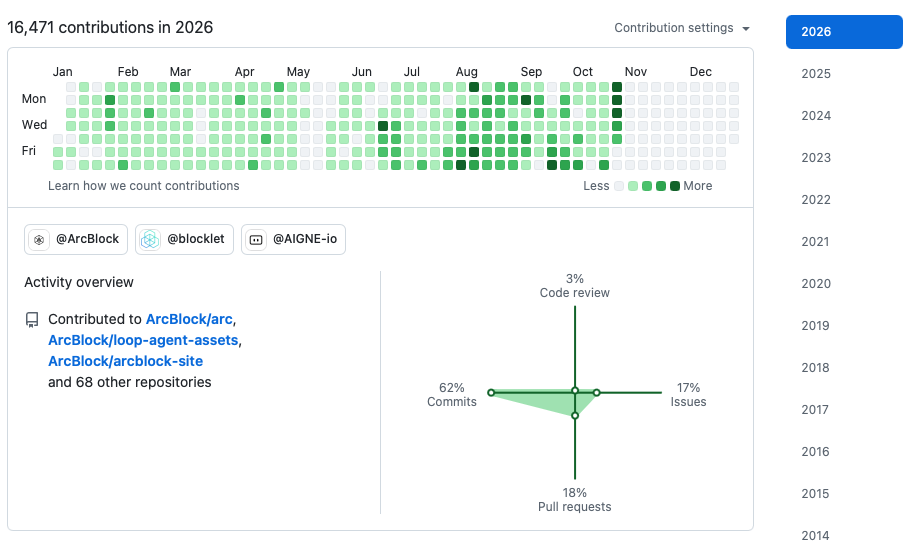
我的 GitHub 贡献记录:截图时,2026 年累计 16,471 次 contributions,包含提交、PR、Issue 与 code review 等活动。
降智不只是一家的问题:它有多普遍,又是否必然?
一次回答出错,可以在具体任务里修正。更麻烦的是,已经使用顺手的工具在一段时间后表现变了:同样需要完成的工作,开始花更多时间,消耗更多额度,还得反复催促和检查。这种不稳定直接影响我能把多少工作交给 Agent。
我在 Anthropic、OpenAI 和 Grok 的产品中,都遇到过工程效用下降的体验,公开记录里也能找到其他用户的对应报告。因此值得正面问:这是一种多普遍的现象?新模型从好用到难用,是必然过程吗?如果不是同一种原因,哪些共同压力会让不同产品走到相似的结果?
这里的“降智”需要拆开看:等待时间、额度能完成的工作量、逻辑和指令遵循、文字可读性、过度工程,以及完整流程是否更容易中断。Codex 主要让我不满的是慢和 overengineering,并不是同样明确的智力下降。把不同症状放到一起研究,不等于先认定它们有一个共同后台原因。
我的日常用法是开发真实项目,通常选择 medium 或 high,而非每次都使用最高推理强度;这些档位也不是跨厂商统一的计算单位。以下评价主要来自持续使用的体感,辅以同期帖子、具体案例和可核查报告,没有逐次保存所有任务和配置,不能换算成精确发生率。带着这个范围,再来看变化怎样发生。
我的使用时间线
这些工具接手的是同一个项目中的不同任务。下面按有把握的日期排列;没有把握的版本更新时间不补猜。Grok 的三个节点保留同期原帖,而不是只用今天的记忆回溯。
2025 年十二月左右 · 团队开始转向 Claude Code
我们开始把 Claude Code 用进团队的产品开发。从 2026 年一月起,我个人的使用也进入高强度阶段,并持续混用不同厂商的 code agent。
2026 年 1 至 2 月 · Claude Code 是主力
我对 Claude Code 相当满意,维持着两个付费账户。这是后续比较的个人起点,尚没有统一任务的逐次测量。
2026 年 2 月左右 · 开始用 Codex 做 code review
我开始主要用 Codex 做 code review,欣赏它的严谨。当时 Claude Code 仍是我的主力编程工具。
2026 年 3 月 · Claude Code 的体验开始变化
大上下文开放前后,我开始明显感觉体验变差。可用窗口、实际输入长度、模型版本和客户端变更,需要分别核对。我没有足够记录把起点锁定到某个具体变更。
Opus 4.6 是 2 月 5 日发布,1M context 当时仍为 beta;3 月 13 日才在 Claude Code 部分套餐中自动开放完整窗口。因此,一月的好体验属于更早的产品状态。[1]
随着 Claude Code 的体验明显变差,我把 Codex 转为主力。那时觉得它用起来已经和 Claude Code 一样顺手,只是一直比较慢。
2026 年 8 月 19 日 · 公开认可 Grok Build
我在 X 上说,它是当时我认为最好的 code agent,开始考虑调整其他工具的订阅。
2026 年 9 月 2 日 · Grok 成为主力
第二条帖子落在实际 bug fixing 上:当时使用的 Grok Build 4.6,对我而言已经超过此前的 Claude Code。任务和配置没有被控制成 benchmark,但这是当时留下的判断。
让我满意的不只是速度,还有指令遵循、主动推进和工作完整度。一个 SuperGrok Heavy 账户能承担原来两个 Claude 账户的不少工作,我因此取消了一个 Claude 订阅,后来又加了第二个 Heavy 账户。正面评价持续了一段时间,也改变了实际付费选择。
2026 年 10 月 29 日 · 公开更正 Grok 好评
后来的体验是速度下降、额度消耗加快,主动性和既定流程的执行也变差。我回到此前的帖子,明确更正原来的判断。
这些记录呈现了评价的变化,尚不能识别后台原因,也没有证明 4.7 在所有任务上都不如 4.6。新鲜感和预期提高仍值得考虑,但需要与此前持续的正面记录一起解释。
最近,截至 10 月 29 日 · Google 又快又好
因为 Grok 的额度很快耗尽,我尝试了 Google Argon 和 Antigravity。它主动推进,也会等待并处理 review,再次让我有了可以把工作交出去的感觉。观察期还短,后续是否持续,需要继续记录。
Codex:从主力编程到长期承担 review 和文字协作
Codex 的慢,对我来说并不是后来才出现的变化;从使用初期起,它就一直偏慢。后来某次较大的版本更新后,我感到 overengineering 更严重了:小任务也会花很长时间探索,再引入不必要的设计和代码。我记不清是哪次更新、具体几月,因此不能把这段体感对应到某个版本。即使最终代码可以工作,等待、审查和维护额外代码仍然是成本。
这种倾向也出现在 code review 里,而且现在仍然存在。有时它会反复提出一些我认为几乎不可能发生的边界情况,或者对当前改动影响很小的问题。每一轮都能再找出意见,处理完一轮,下一轮又有新的意见,review 像是永远结束不了。其中有些确实值得修,有些则很难说明值得投入多少时间。能继续找出问题,与能判断哪些问题值得阻止交付,是两种不同的能力。
这已经影响到我们的流程设计。我们在 skill 里设了硬规则:code review 最多三轮;到第三轮仍有争议、难以取舍的问题,就让多个 Agent 做一次 jury,共同审视剩余意见,而不是让同一个 reviewer 无限追加要求。这是实际使用中为避免 review 无法收敛而加上的约束。对我来说,Codex 的 overengineering 不只是代码写多了,也包括审查耗时过长,以及对低概率风险和次要意见投入过多。
现在,我的主力编程 Agent 会在 Claude Code、Grok Build、Antigravity 之间切换,Codex 则长期承担两件事:code review,以及帮我写各种文案。这篇文章也是我和 Codex 一起完成的。到目前为止,单论文字协作,我仍然觉得 OpenAI 的模型总体比较好。
这也是为什么我不想把所有变化都简单叫作“变笨”。我没有同样明确地感到 Codex 的智力下降;它在 review 和文字上的价值一直存在,但速度和过度工程影响了我是否愿意把它当作主力编程工具。同一个工具在不同任务上的评价,可以同时成立。
一个具体的流程失败
我在 skill 中写过完整流程:实现修改,提交 PR,等待 GitHub 自动触发的 Codex review,处理评论并修复,核对最新提交的检查,在授权范围内合并,清理工作区、更新 main,再构建最新版本。
如果想了解这套流程具体怎样运行,可以看我之前的两篇记录:从手工循环到成对 skill 的 loop engineering 实战,以及无人值守的 issue/PR 循环。两篇都链接到我们开源的 Agent Loop skills。具体指令、流程约束和修改历史都可以查看,读者也可以据此判断我们的用法是否合理、问题是否出在流程设计上。
早期 Grok Build 会主动走完。后来,它经常停在“PR 已提交,还没 merge”,需要提醒才继续,有时还会漏掉 review、修复或最终构建。
有一次测试出了问题,我追查后发现没有构建最新版本。要求构建后,又遇到 build break;Agent 随后以新版本构建失败为由,继续使用旧版本。
这个案例中的可观察失败是:新改动没有完成构建和验收。保留旧版本维持运行可以合理,但新任务仍然处于被阻塞的状态。代码生成是否正确、流程能否持续执行、验收对象是否对应目标提交,需要分别记录。单靠这一次失败,不能判断原因在模型、上下文管理还是工具的停止策略。
讨论群里的三种解释
我把这些体验带到一个五百多人的 AI coding 讨论群,想了解是不是只有我这样感觉。在这段对话里,三位回应者提供了不同角度。下面保留他们的群内 ID,并转述观点。
野生皮卡丘认为自己也遇到过真实退步,同时提醒,新模型初期的新鲜感,以及用熟后要求提高,也会影响体感。他倾向于把更大部分变化归为产品本身,并推测厂商可能在吸引用户后调整算力投入。前一部分是使用感受,后一部分是对厂商动机的推测;他给出的主观比例不能当作测量结果。
Cal Art Academy说自己已经经历过几轮类似变化,因此会换工具。他提出一种直觉解释:大量用户不断提供良莠不齐的反馈,模型可能在这个过程中变差。这个解释需要核对反馈究竟怎样进入训练与部署,不能直接理解成每次对话都在实时修改共享模型。
谷雨提出,服务背后存在 routing,也有可调整的参数。这给调查指出了产品层面的方向,但这段对话没有提供能够识别某次实际路由或参数变化的日志。
这些回应使我更有理由继续收集记录,也暴露了一个分歧:有人从习惯和预期解释,有人从训练反馈解释,有人从运营与服务配置解释。这是三人的主动回应,不能代表全群,也不能用来判定哪种解释已经成立。
公开报告的时间线
个人时间线之外,下面是我能核对的原始材料。每个节点注明它属于官方复盘、独立测试还是用户报告,避免把不同强度的证据混在一起。
2025 年 4 月 · OpenAI 确认行为更新回归
OpenAI 在 5 月 2 日的 Expanding on what we missed with sycophancy中,复盘 GPT-4o 更新带来的迎合性问题及回滚。它说明行为调整可能使产品退步;本文后面会把它与用户怀念的对话体验分别讨论。
2025 年 8 至 9 月 · Anthropic 确认基础设施故障
Anthropic 在 9 月 17 日的 A postmortem of three recent issues中,确认多项基础设施故障影响回答质量。服务实现可以改变用户结果;这是 2025 年的事件,不能移到我的 2026 年三月时间线上。
2026 年 3 至 4 月 · Claude Code 的三类变化
Anthropic 在 4 月 23 日的 An update on recent Claude Code quality reports中确认:3 月 4 日把默认 effort 从 high 调到 medium,4 月 7 日撤回;3 月 26 日引入的闲置会话 bug 会持续清除旧推理,4 月 10 日修复;4 月 16 日的精简输出提示影响编码质量,4 月 20 日撤回。[2]
谈到降低默认 effort,复盘直接写道:
“This was the wrong tradeoff.”
(译:这是一次错误的取舍。)
这是已有记录的产品取舍及故障,不只是体感。但三类问题发生时间不同,其中 3 月 26 日的 bug 无法解释更早的起点。
2026 年 4 月 2 日 · 复杂工程用户的报告
stellaraccident 在 Claude Code #42796中,报告指令遵循和完成声明问题,并附事后日志分析。它提供了具体调查线索;读取次数或可见思考文字仍不能直接换算成真实推理预算。
2026 年 5 月 · 每日仓库修复测试出现波动
JB 在 5 月 29 日的 MarginLab 报告中,记录 SWE-Bench-Pro 子集测试下降,并提出判断:
“This appears to be a harness issue, not a model regression.”
(译:这看起来是外围 Agent 程序的问题,而非模型本身退化。)
这是报告作者的归因判断。测试中 CLI 也在更新,无法隔离底层模型。原表还显示 5 月 27 日已恢复到 66%,早于正文所说的 5 月 28 日新模型发布;因此我保留产品波动记录,不采用“新模型发布造成恢复”的因果叙述。[3]
2026 年 6 月 13 日 · Codex 用户报告任务变慢
mazukabz 在 Codex #28077中,报告任务由原来不到约 5 分钟变为 30 至 50 分钟。这个症状与我的体验相似。数字属于报告者,不能当作我的测量,也不能当作官方故障率。
截至 2026 年 10 月 29 日 · 固定客户端测试未检出变化
ninjahawk 的 LiveNerf固定客户端和测试条件,在两个完整十日窗口中均未检出变化。
这是需要保留的反向结果。它主要测试知识和数学题,并非完整开发流程,也有检出能力限制。它与 MarginLab 测量的对象不同,不能合并成一条统一的“模型降智曲线”。
其中的官方复盘确认了具体退化机制,用户报告提供了调查线索,但仍未解释本文的 Grok 变化。当前材料支持“多家产品出现过类似报告”,尚不足以确定每家都存在相同周期或共同原因。
发布 benchmark 为什么不能直接预测日常体验
模型发布时的图表通常在回答:在指定评测和配置下,它能达到什么成绩。我日常使用需要回答的,还包括在 medium 或 high 下是否省时,遇到异步 review 是否继续推进,以及是否留下不必要的改动。
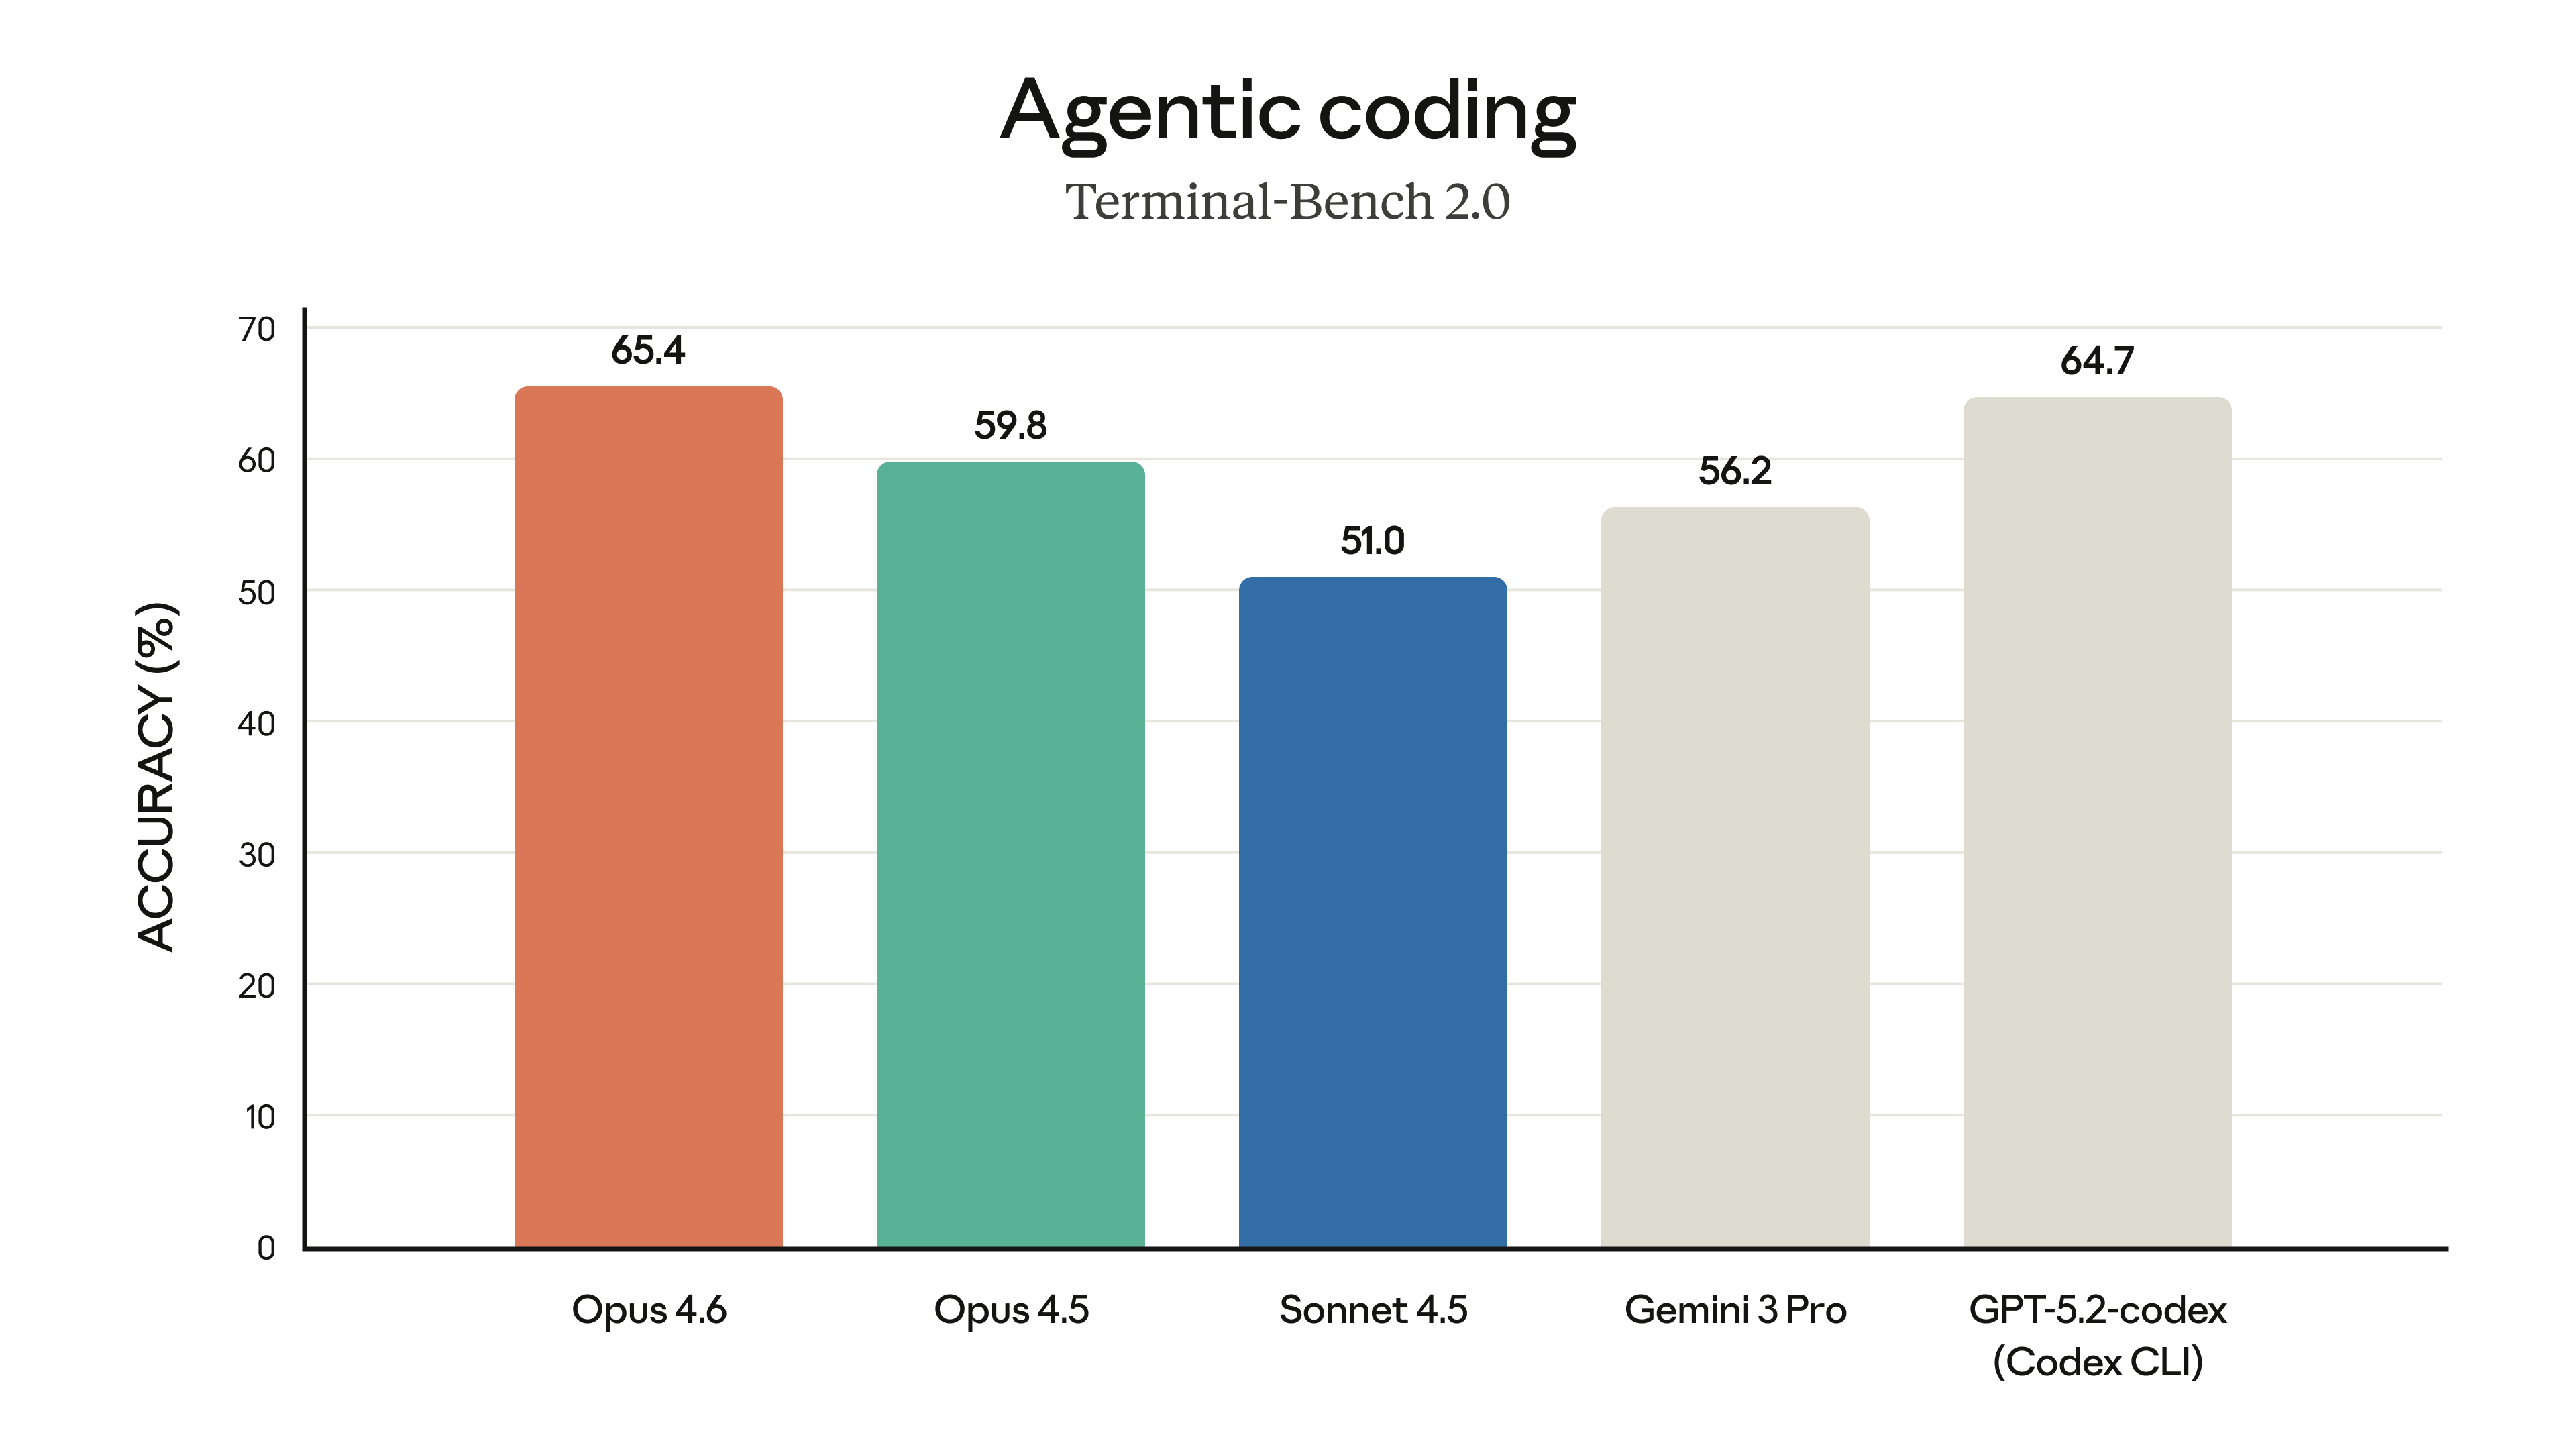
图:Anthropic 的 Opus 4.6 发布材料。原图与评测说明见官方发布页。它记录发布评测,不是本文的实测,也不是上线后稳定性的时间序列。
| 发布材料 | 原报告展示了什么 | 与本次观察怎样比较 |
|---|---|---|
| Opus 4.6,2 月 5 日 | 报告编码等评测改善;同时说明深度思考可能增加简单任务的延迟,建议必要时降低 effort | 发布成绩与后续默认配置、上下文和客户端变化分别记录 |
| GPT-5.6,7 月 9 日 | Coding Agent Index 的突出成绩使用 max;同页也单独报告 medium 下的其他评测结果 | 不能把 max 的编码成绩直接视为我日常 medium/high 的表现;也不能把所有发布结果一概称为最高档 |
| Grok 4.7,9 月 21 日 | 主要对比标为 xHigh,DeepSWE 的星号结果另注明 high;报告更好的编码、自检和长上下文能力 | 新版本发布的改善声明,与我十月体验下降并列存在,需要相同任务、配置的对照才能解释差异 |
| Gemini 4 Argon,10 月 13 日 | Google 展示其新模型能力及评测结果 | 与我当前正面体验方向一致;还没有足够长的观察窗口 |
我没有复跑这些发布测试,也没有把不同厂商、不同版本的 benchmark 分数拼成排名。它们与长期使用记录衡量的对象有重叠,却并不相同。新版本在某项评测上更强,产品在另一种配置或更长的工作流程中变得更难用,这两件事可以同时发生。
初步分析:共同压力,未必是同一种原因
商业取舍是真实变量,故意削弱仍需证据
厂商需要处理推理计算、响应时间和额度之间的取舍。Anthropic 的四月复盘提供了一个有记录的例子:为降低高 effort 的延迟,把默认档位改低;用户反馈后又撤回。这是明确的产品取舍及其后果,不能只用“错觉”解释。缓存与上下文故障则是另一类问题,即使没有降低能力的意图,也会同时伤害效果和使用成本。
因此,我的初步判断是:多家产品可能面对相似的优化压力,但各自通过不同设置、提示和服务实现,把压力传递到用户体验上。这个解释有官方案例支持,尚未证明它就是 Grok、Codex 或每一次变化的原因。
群里“先让用户爽,再有意削弱”的解释,比“运营取舍可能伤害体验”多了一层动机判断。要确认它,需要同条件的持续测量,以及能对应上实际策略变更的材料。当前材料足以要求厂商解释变化,还不足以把这套商业剧本写成事实。用户不会因为后台是 bug 还是优化,就少承担一次返工;但研究上仍要区分。
从 GPT-3.5 的写作,到 4o 的对话体验
这种落差并非到 coding agent 才出现。GPT-3.5 时期,我已经觉得它的写作很出色;后来 4o 给我的印象尤其有温度,交流自然。这些体验分别涉及写作质量和交流感受,需要与具体任务一起理解。
早期写作能力有具体研究可供参照。Brian Porter 与 Edouard Machery 的 2024 年诗歌研究使用 ChatGPT 3.5,发现非专业读者难以分辨其诗作与人类作品,并在多项评价上更偏好 AI 诗作。研究涉及特定诗歌与读者群体,不能由此授予模型一个通用文学等级。[4]
GPT-4o 发布于 2024 年 5 月 13 日。后续升级中的对话体验争议,也不全是回忆:OpenAI 的 2025 年 8 月发布记录写明,8 月 12 日把 4o 放回付费用户的模型选择器;8 月 15 日因用户认为 GPT-5 太拘谨、太职业化,调整其默认性格,使交流更温暖。[5] 这能确认体验反馈及产品回应,不能代替对所有用户或写作任务的调查。
OpenAI 对 2025 年四月 4o 迎合性回归的解释,是某次更新过度重视短期反馈,随后回滚。我的疑问是:纠正迎合,为什么会被一些用户体验为整个交流变差?温度、清楚表达与不加判断地附和,应分别评价。OpenAI 的八月记录本身也区分温暖与迎合,并报告其性格调整未增加内部评测中的迎合性。用“以前太迎合”概括用户失去的全部体验,解释仍然不够。
这段历史不能证明新模型的写作全面不如旧模型,但它为 coding agent 中的困惑提供了一个参照:能力、安全行为和沟通体验可以沿不同方向变化,需要分别验收。
为什么越来越“不说人话”?
这部分是我在多个工具中的感受,目前缺少固定写作任务和盲评数据,不能说已经量化证明它们的写作能力普遍下降。不过,查到的原始材料提供了几条值得检验的路径。
面向编程工具的输出目标,可能与面向人的解释不同。OpenAI 的 GPT-5 prompting guide记录了 Cursor 的集成体验:过多进度播报和事后总结打断使用流程,而代码又可能因过度简写难读。文档还把 verbosity 与 reasoning effort 分开控制。[6] 这说明会写代码、思考多久、最后怎样向人解释,是可以分别变化的维度。
压缩表达也可能压掉完成工作所需的信息。Anthropic 的四月复盘披露,限制工具调用间文字与最终回答长度的系统提示影响了编码质量,后来被撤回。它确认的是这个具体改动的后果;它没有证明所有简短回答都差,也没有证明三家都用了同一套提示。[2]
偏好优化不一定奖励真正好读的内容。Ryan Park 等人的 Disentangling Length from Quality in Direct Preference Optimization研究了训练如何利用对长回答的偏好。[7] 它提示了一种风险:长度、格式或看起来完整的程度,可能成为质量的替代指标。反过来,强制短也不是自动修复。该研究不能用来断言某家当前模型采用了相同训练方法或发生了同样回归。
更长的工具使用历史也值得检查。Anthropic 的 Effective context engineering for AI agents讨论了持续累积的工具输出、历史和指令对上下文管理的压力。[8] 这能说明 coding agent 与最初单轮写作场景不同,却不能单独解释某一次难读输出。
这些材料让我更倾向于先检验:产品是否在追求代码成绩、完整格式、少输出或低延迟时,降低了向人清楚解释的优先级。它是可检验的初步假说,不是已确认的跨厂商共同原因。下一轮记录应加入固定写作任务与匿名对照,判断读者能否准确还原改了什么、为什么改、验证了什么,而不是只数输出有多长。
还有哪些容易混在一起的因素
模型权重、effort、系统提示、上下文压缩、工具实现与服务路由,不能只靠一个模型名区分。Grok Bot 与 Grok Build 的任务环境也不同;4.7 发布材料提到对 Bot harness 的训练,Bot 的正面口碑并不直接回答 Build 中的投诉。
排队主要增加等待,重复工作、额外工具调用和缓存失效则可能增加消耗。Xingyu Chen 等人的 overthinking 研究讨论了简单问题上的过多推理;Nelson F. Liu 等人的 Lost in the Middle讨论上下文中信息位置带来的影响。它们提供研究路径,不能直接量化我的损失。
一般的固定权重推理不会因为其他用户刚发来一条消息,就实时修改共享权重。反馈可以影响后续训练与部署,OpenAI 的迎合性复盘正提供了这样的更新案例。但从“有反馈”到“这次因此变差”,仍需要一条具体证据链。
项目越来越复杂、预期提高、新工具继承旧工具的调查,以及在特别失望时切换所带来的回归均值,也都会影响比较。它们与已确认事故可以同时存在,不必先选一个来解释全部体验。
开发者怎样应对,以及低切换成本意味着什么
对我来说,先要把比较条件从记忆里拿出来。保留少量可重复的真实任务,记录模型、客户端、effort 和上下文条件,再比较完成时间、消耗、人工接管、无关改动及最终结果。在匹配任务上只调整 effort,再比较多等的时间是否换来了更少返工;直接把所有任务都开到最高档,既不符合我的日常用法,也绕开了问题。
交付的证据应保存在工作产物里:目标提交是什么,review 是否处理,最新构建与验收对应哪一版。失败时保留阻塞状态。沟通也要进入验收条件,要求解释具体改动和测试结果,检查是否忠实反映实际执行,而不是把漂亮的完成声明当作证据。固定任务、写作盲评和连续指标记录仍是下一步方案,我没有把它写成已经部署的系统。
另一个实际应对是保留替换工具的能力。我从 Claude 转到 Grok,再因额度和体验变化尝试 Google;这些迁移已经发生。在我把代码、流程和验收条件留在项目里的情况下,一款工具曾经让我满意,并没有阻止我把下一项工作交给另一款。
这也是我怀疑模型与 coding agent 的用户粘性很弱的原因。对我这种使用方式,连续几次任务完成得怎样,比曾经喜欢哪个品牌更直接地影响选择。它不能证明整个市场的粘性接近零:其他人的会话历史、集成和团队流程可能带来迁移成本。但至少对我而言,换工具的成本低,使用习惯不足以抵消持续变差的体验。
如果这是更多开发者的处境,厂商需要建立的优势就不能只有一次发布排名。配置变更是否透明,回归能否及时识别,用户能否复现并报告,真实工作能否稳定完成,都可能影响持续选择。这是从我的迁移经历得到的产品判断,不是一个已经测量出来的市场结论。
换了工具,问题还没有结束
Anthropic、OpenAI 和 Grok 的相似体验,让这个问题值得跨厂商调查。公开复盘确认了某些退步,同行和用户报告补充了观察,LiveNerf 又限制了“每个模型必然变差”的推断。现在就把所有变化归为错觉,或者归为统一的商业阴谋,都解释得过快。
我想继续记录的是:在日常 medium/high 档位下,速度、效果和可读性随时间怎样变化;产品内部节省的计算,是否变成了用户的返工;以及当更换工具这么容易,什么才能让开发者持续选择同一个 Agent。
写到这里,Google 最近又接连公布了 Argon 和 Carbon。[9] 这几天,我已经把主力开发工作切到了 Google,实际使用的是 Argon 和 Antigravity。它又快又能干,额度也让我觉得宽裕。经历了这一周的折腾,现在能把一件工作交出去,不用每个节点都补一句“继续”,的确让我轻松了不少。
但这种轻松,我在 Claude 和 Grok 上也有过。眼前的工具很好用,我没有理由替它预写一个退步的结局;同样,也很难把过去的经历当作没有发生。
再过一段时间,我还会不会又回到今天的位置,去找下一个让我觉得又快又好的 Agent?我希望这一次能保持下去,也想把后面的过程认真记下来。
参考
- Anthropic. Introducing Claude Opus 4.6, 2026-02-05;1M context is now generally available, 2026-03-13。 ↩
- Anthropic Engineering. An update on recent Claude Code quality reports, 2026-04-23。 ↩
- JB, MarginLab. Claude Code degraded for the week before Opus 4.8's release, 2026-05-29。原表 5 月 27 日 66%,5 月 28 日 72%。 ↩
- Brian Porter, Edouard Machery. AI-generated poetry is indistinguishable from human-written poetry and is rated more favorably. Scientific Reports, 2024。 ↩
- OpenAI. Hello GPT-4o, 2024-05-13;ChatGPT release notes, 2025-08-12/08-15;Sycophancy in GPT-4o, 2025-04-29。 ↩
- OpenAI. GPT-5 prompting guide,Cursor 集成、verbosity 与 reasoning effort 相关章节。 ↩
- Ryan Park, Rafael Rafailov, Stefano Ermon, Chelsea Finn. Disentangling Length from Quality in Direct Preference Optimization, 2024。 ↩
- Anthropic Engineering. Effective context engineering for AI agents, 2025-09-29。 ↩
- Google. Gemini 4 Argon, 2026-10-13;Gemini 4 Carbon, 2026-10-28。Carbon 公告为分阶段有限开放,不属于本文的实际使用记录。 ↩