GraphQLが分散型ウェブの原動力になる
ブロックチェーンとストレージネットワークをデータの相互運用性レイヤーとして活用する
著者: Brandon Ramirez
数十年の間、唯一広く使われてきたデータベースはSQLデータベースであり、それは今でもほとんどの組織、ソフトウェアアプリケーション、機関の中核に位置しています。しかし、ブロックチェーンの登場により、ついにリレーショナルデータベースに代わる選択肢が現れました。それはNoSQLムーブメントがもたらした漸進的な改善の話だけではありません。私たちは、独自のAPIではなくデータそのものが相互運用性のための基本的な基盤となる、分散型ウェブ(Web3)と呼ばれる新しいパラダイムの入り口に立っています。この記事では、なぜこの移行が起きているのか、そしてGraphQLというクエリ言語がいかにしてこのデータ相互運用性の新時代を牽引する独自の地位にあるのかを説明します。
独自のAPIが抱える問題
今日のウェブは、独自のアプリケーションプログラミングインターフェース(API)を介して接続されています。これらは主に、中央集権的な(通常はSQLの)データベースの制限を解決するために存在しています。この現状について、元Ethereum財団のVinay Gupta氏は次のように述べています。
「組織の中心に、すべての真実と知恵を蓄積した一つの大きなデータベースがある場合、他の人にそのデータベースを触らせることを非常にためらうものです。」
そのため、サーバー上で動作する独自のAPIが中央データベースを保護するバリアとして機能します。APIは、誰が、どのような形式で、何を入れ、何を出すかを制限します。マイクロサービスパターンでは、組織内であってもデータをカプセル化するため、異なるチームによって構築されたサービス同士も互いのAPIを経由しなければなりません。これにより今日まで発展してきましたが、APIの乱立には以下の欠点があります。
- APIは硬直的で、メンテナンスコストが高い。
- 現在のモデルは非効率である。
- 独自のAPIはデータの独占につながる。
これらを詳しく見ていきましょう。
1. APIは硬直的で、メンテナンスコストが高い
API、特にREST API(これについては後述します)は、ウェブアプリの特定の機能などのユースケースを念頭に置いて設計されており、それらのユースケースから離れれば離れるほど、利用が困難になります。
組織内では、これがAPIサーフェスエリアの絶え間ない拡大を招きます。新しい機能が追加されるたびに、新しいエンドポイントをAPIに追加するためのエンジニアリング作業が必要になります。そして、新しい各エンドポイントは、使用されている期間(非常に長期間になることもあります)にわたって維持・サポートし続けるための継続的なエンジニアリング作業を必要とします。
一方、パブリックAPIの利用者にとっては、API開発者がサポートすることを決定したユースケースに縛られることになります。Githubのエコシステムエンジニアリング・ディレクターであるKyle Daigle氏は、この問題を明確に述べています。
「ほぼすべてのAPIは、その設計によって統合を推進します……私が思いつくすべてのAPIは……それらをどのように使用してほしいかという一種のアイデアを持っており、もしそれに背こうとすれば、基本的には不可能です……大量のデータをスクレイピングしてデータベースに保存し、本質的にその周りに独自のAPIを構築しなければなりません。」
これらのパブリックAPIの硬直性を回避するためには膨大なエンジニアリングの労力が必要となり、それが次のポイントにつながります。
2. 現在のモデルは非効率である
これまで見てきたように、APIの硬直性は、単に形式が異なったり、異なるAPIセマンティクスの背後にあったりするだけの全く同じデータを保存するために、さらなるデータベースやAPIの増殖を招きます。これらの新しいデータベースやAPIのそれぞれが、維持のために追加のインフラとエンジニアリングリソースを必要とします。
また、それは信じられないほどの遠回りを生みます。再びVinay Gupta氏の言葉を引用します。
「IRS(アメリカ内国歳入庁)にフォームを提出すると、データベースに登録されるまでに6、7のプロセスを経ます……コラボレーション全体が間接的で、官僚的で、困難なのです。」
研究データの文脈におけるこの問題を説明した論文の中で、Brendan O’Brien氏とMichael Hucka氏は、SQLデータベースの優位性を「中間に位置するデータベース(database in the middle)」パターンとして次のように表現しています。
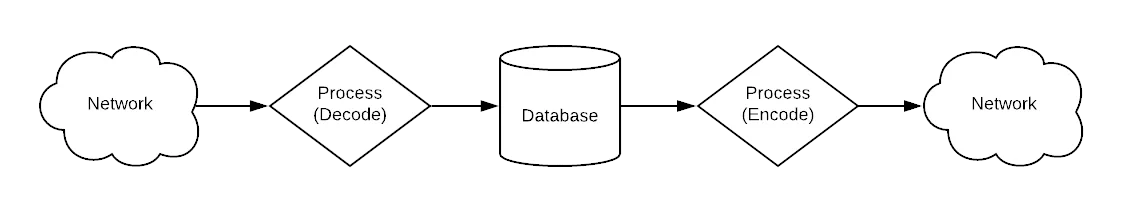
「中間に位置するデータベース」パターン。出典:https://qri.io/papers/deterministic_querying/ より改変
十分に複雑なソフトウェアシステムであれば、一つのデータベースからデータをエンコードし、ネットワーク経由で提供し、データをデコードし、別のデータベースに入れるというプロセスを何度も繰り返す無数のサーバーが含まれることになります。
O’Brien氏とHucka氏は続けて、こうしたデータパイプラインにおいて、中間結果を公開するために必要なエンジニアリングの労力のせいで、その結果がプライベートなデータベースに保存されたままになったり、完全に破棄されたりすることが一般的であると説明しています。その結果、データパイプライン内、および孤立したチームや組織によって作成されたデータパイプライン全体という、二つの次元での重複が発生します。
3. 独自のAPIはデータの独占につながる
データをサイロ化する必要性は、モラルハザードも引き起こします。大手テック企業が、以前は開発者に自社プラットフォーム上での構築を推奨していたにもかかわらず、独自のAPIへのアクセスを取り消すという話は、テック界隈ではよくある物語になっています。
Facebookは競合を抑え込むために意図的にそれを行い、Twitterはデータをより効果的に収益化するためにそれを行いました。InfoWorldのシニアライターであるSerdar Yegulalp氏はTwitterの事例を取り上げ、独自のAPI上で構築することのリスクを簡潔に表現しています。
「これをAPIエコシステムの職業病の一つと呼んでいいでしょう。データソース、分析レイヤー、あるいはインフラとして、単一のエンティティへの依存が広がり多面的になるほど、足元の絨毯を引っこ抜かれるリスクは高まります。」
ゲートキーパーの背後にデータを置くことを必要とするソフトウェアアーキテクチャのパラダイムは、必然的にこうしたデータ独占による有害な慣行を招きます。
あまりに不公平にならないように付け加えておくと、APIベースの接続は大きな成功を収めてきました。APIは、StripeやTwilioのような小規模で専用のサービスからソフトウェアを構成できるようにすることで、計り知れない経済的価値を生み出しました。また、SQLが主流であった旧来のテクノロジー環境において、アプリケーション間でデータを安全に転送する方法を提供してくれました。今日私たちが享受しているインターネットは、APIなしには存在しなかったでしょう。しかし今、ブロックチェーンやその他のWeb3テクノロジーの登場により、私たちはインターネット上で摩擦のない相互運用性の新時代に入るチャンスを手にしています。
ブロックチェーンとコンテンツアドレス指定型ストレージの登場
SQLやほとんどのNoSQLデータベースの欠点の核心にあるのは、データをその場で変更(ミューテート)する情報モデルを採用していることです。Clojureプログラミング言語とDatomicデータベースの作成者であるRich Hickey氏は、これを「場所指向プログラミング(place-oriented programming、PLOP)」と呼んでいます。これはかつて、メモリやディスク容量の制限を克服するために必要でしたが、現代の情報モデルにおいてはもはやその場所はありません。データがその場で任意の方法で変更される可能性がある場合、そのデータが正しいことや、最後にアクセスしたときから足元で変更されていないことを信頼することは不可能です。したがって、分散型ウェブを可能にする二つの技術であるブロックチェーンとコンテンツアドレス指定型ストレージの両方が、情報モデルにおいて不変性(イミュータビリティ)を強調しているのは驚くべきことではありません。
コンテンツアドレス指定型ストレージ
ブロックチェーンの方が注目されていますが、まずはより単純で基礎的な概念であるコンテンツアドレス指定型ストレージから説明します。その考え方はこうです。データベース内のエンティティ、ファイルシステムのファイル、CDN上のバイナリデータなど、あらゆるデータに対して、どのようにそのデータを参照するか? 問い合わせ方によって異なるデータを指す可能性がある任意のID、URL、または名前を付けるか……あるいは、どこから提供されるか(自分のローカルファイルシステムか、リモートサーバーか、あるいは他の惑星か)に関わらず、常に、そして永遠に特定の値を指し示す一意のIDを付けるか?
Interplanetary File System (IPFS) や分散型バージョン管理システムGitなどのコンテンツアドレス指定型ストレージネットワークは、後者のアプローチを採用しています。これらは、コンテンツ自体から(ハッシュ関数を使用して)一意に計算されたIDを使用します。コンテンツIDは常に同じコンテンツを返す必要があり、それを使用してIDを再計算できるため、データの整合性を検証することは極めて容易です。
ここで、「コンテンツアドレス指定型ストレージが不変であるなら、どうやって役に立つことができるのか?」という疑問が湧くかもしれません。結局のところ、銀行の残高、友人リスト、ToDoリストなど、私たちがデータを表現するために使用する現実世界のものは、時間の経過とともに変化します。不変のデータを中核的な構成要素として使いながら、時間とともに変化する概念をどのように表現すればよいのでしょうか? そこでブロックチェーンの出番です。
ブロックチェーン
ブロックチェーンは、その本質において、不変の値の「追記専用(append-only)」データ構造、つまりブロックの連鎖です。各ブロックは不変で変化しませんが、口座残高やスマートコントラクトの状態などの変数がブロックごとに異なる値を持つようにすることで、可変性を模倣することができます。このパターンにより、監査可能性が無料で手に入ります。つまり、時間の経過とともに変数がどのように変化したかを確認できるため、外部プロセスが確信を持ってこのデータに直接依存できるようになります。
Ethereumのようなスマートコントラクト機能を備えたブロックチェーンは、データの変更方法や変更できる人を安全に体系化する方法も提供します。これは従来、中央集権的なAPIの役割であった責任です。
これらのイノベーションは、ブロックチェーンやコンテンツアドレス指定型ネットワークに保存されたデータが相互運用性レイヤーとして機能する新しいパラダイムを切り拓きます。
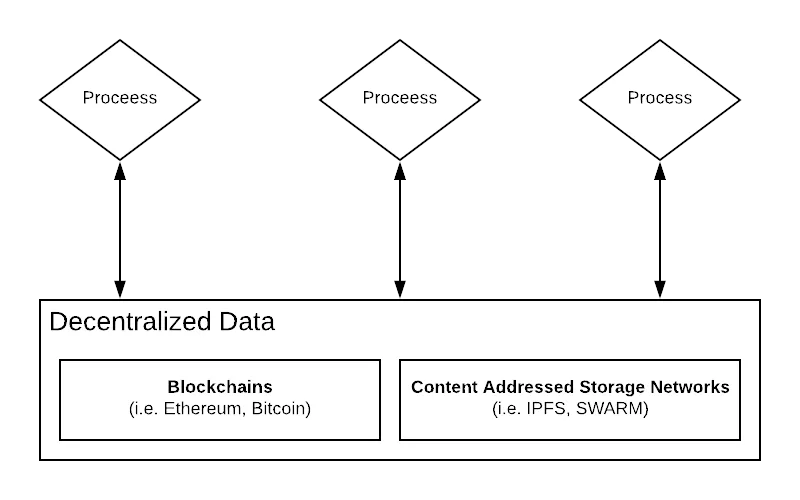
相互運用性レイヤーとしての分散型データ
ブロックチェーンは分散型でパーミッションレスであり、敵対的な環境で動作するように設計されているため、セキュリティと堅牢性を確保するために特別な保護層の背後に隠す必要はありません。ブロックチェーンやコンテンツアドレス指定型ストレージネットワーク上のデータにとって、独自のAPIはもはやアーキテクチャ上の必然ではありません。プロセスは、相互運用性のための共有基盤として、分散型データと直接対話できるのです。
分散型データのクエリ
ブロックチェーンが新しいタイプのデータベース・プリミティブであるならば、そのデータをどのようにクエリするのでしょうか? RESTful API、RPCコール、SQLインターフェース経由でしょうか? 答えは必然的に「そのすべて」になりますが、ブロックチェーン上に構築され、コンシューマーグレードのパフォーマンスを提供することを目指す分散型アプリケーション(dApp)にとって、GraphQLは自然な選択です。
GraphQLはRESTやRPC APIよりも効率的である
GraphQLは、クエリ言語であると同時にインターフェース定義言語(IDL)でもあり、Facebookによって発明されオープンソース化されました。これは、この記事で前述した従来のRESTful APIの硬直性と非効率性を克服するために設計されました。GraphQLは、強力かつエルゴノミック(使い勝手が良い)なクエリ言語をAPI利用者に直接公開することで、これを実現しています。
従来のREST(Representational State Transfer)APIでは、各エンティティやリソースに、そのエンティティについて受け取るデータを定義する個別のエンドポイントがあります。たとえば、ユーザーが所属する組織の名前を取得するには、まず以下を呼び出す必要があるかもしれません。
/api/v2/users/1
その後に次を呼び出します。
/api/v2/organizations/7
従来のAPI上に構築された実際のアプリケーションは、数十回から数百回の往復ネットワークコールを行う可能性があります。そして、これはRESTだけの問題ではありません。人気のある分散型アプリケーションであるAdChainは、EthereumのRPC APIを利用しており、UIをロードするためにInfuraに対して数百回の往復ネットワークコールを余儀なくされています。その結果、ネットワークの混雑と最適とは言えないロード時間を招いています。
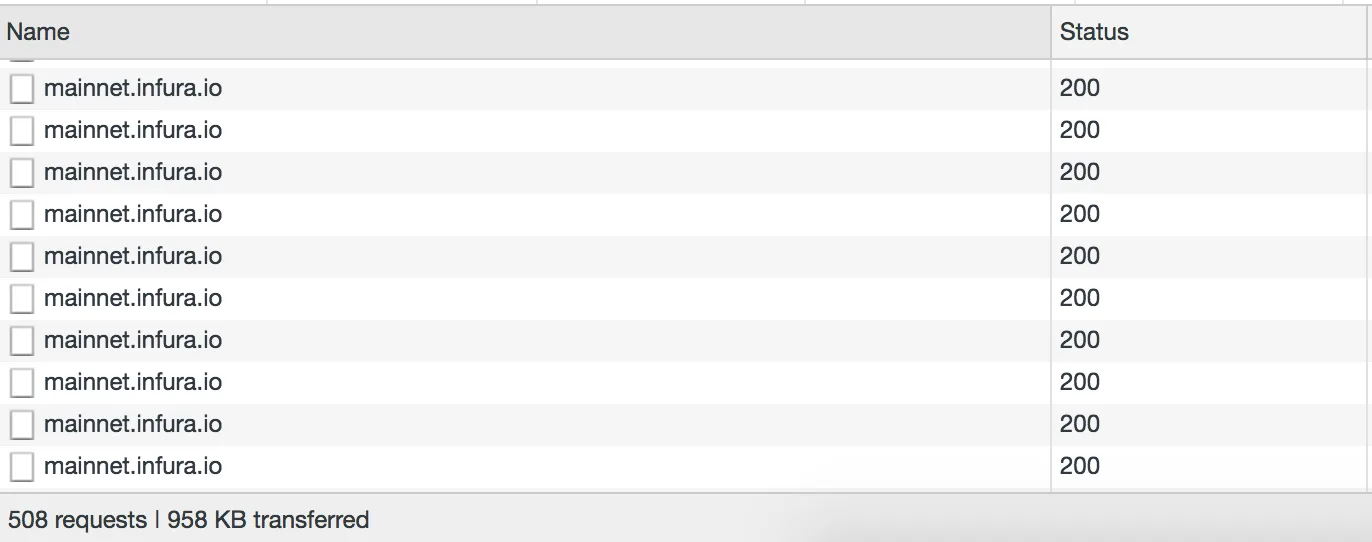
本稿執筆時点での、AdChainレジストリによって行われたInfuraへの数百件のネットワークコール:https://publisher.adchain.com/domains
一方、GraphQLは、アプリケーションが必要とするすべてのデータを単一のクエリで表現できるほど強力です。どれほど多くのデータが必要であっても、GraphQLならネットワークコールは1回で済みます。これは「アンダーフェッチ(過少取得)」問題の解決と呼ばれることもあります。さらに、要求したデータだけを正確に取得でき、それ以上は取得しないため、「オーバーフェッチ(過剰取得)」問題も解決されます。
その結果、インターフェースの消費方法に対する制約が大幅に減り、欲しいデータだけが手に入り、外部の開発者による新しいユースケースをサポートするために絶えず更新する必要がなくなります。
GraphQLは分散型アプリケーションにとってSQLよりも優れている
しかし、一部で言われているように、ブロックチェーンのデータをクエリするためにSQLのような別のクエリ言語を使わないのはなぜでしょうか?
明確にしておくと、私はそれが起こり得るし、起こるべきだと考えています。SQLは世界中で広く普及しており、数百万人の開発者に馴染みがあり、クエリ言語としてGraphQLよりも厳密に強力です。特に、GraphQLに馴染みのないデータサイエンティストやデータエンジニアにとっては親しみやすいものです。とはいえ、ブロックチェーン上に構築される分散型アプリケーション(dApp)に好まれる言語はSQLではないでしょう。
ブロックチェーン上に構築されるdAppにおいて、GraphQLがSQLに勝利する主な理由はいくつかあります。
- GraphQLは「十分に強力」である
- GraphQLはフロントエンド開発者にとってよりエルゴノミックである
- GraphQLは組織間の信頼境界を越えて利用されるように設計されている
詳しく見ていきましょう。
1. GraphQLは「十分に強力」である
GraphQLクエリ言語はネイティブではSQLほど表現力豊かではありませんが、適切に設計されたGraphQLエンドポイントは、SQLクエリインターフェースに期待されるクエリ機能のほとんどを提供するように設計できます。たとえば、GraphQLの仕様にはネイティブに集計(アグリゲーション)を行う方法は規定されていませんが、OpenCRUDのような標準が登場し、この機能を公開する方法を規定しています。
エンティティ間のアドホックな結合(JOIN)など、GraphQL APIでは常に手が届かないであろうロングテールな機能は依然として存在します。しかし、フロントエンドアプリケーションに必要なユースケースの99.9%において、GraphQLで十分であると私は推定しています。
2. GraphQLはフロントエンド開発者にとってよりエルゴノミックである
GraphQLを選択することで失うわずかなパワーの代わりに、使い勝手(エルゴノミクス)が手に入ります。たとえば、GraphQLは馴染みのあるJSONのような構文を持っています。
   query {
   user(id:1) {
   name
   organization {
   name
    }
   }
   }
そして、GraphQLクエリのレスポンスは、リクエストの形状を正確に反映したJSONオブジェクトです。
{
"user": {
"name": "Vitalik",
"organization": {
"name": "Ethereum Foundation"
}
}
JSONがウェブ上でデータを送信するために最も一般的に使用されているデータ形式であることを考えると、この構文はほとんどのウェブ開発者にとって非常に親しみやすいものです。
一方、同等のSQLクエリは次のようになります。
SELECT user.name, organization.name
FROM user JOIN organization ON (user.organization_id=organization.id)
WHERE user.id=1
見るに耐えないものではありませんが、GraphQLクエリほど直感的ではないと言えるでしょう。
また、レスポンスデータは非正規化されたテーブル形式になり、使用している特定のSQLデータベース固有のバイナリプロトコルで送信されます。これは、HTTP経由で送信されるプレーンテキストのJSONとして表現される、GraphQLレスポンスの直感的なネスティングとは対照的です。
GraphQLのエコシステムには、React-Apolloのようなツールもあり、GraphQL経由で取得したデータをウェブアプリケーションのUIコンポーネントに直接統合することが非常に簡単になっています。SQLはモバイルやウェブアプリケーションからHTTP経由で直接消費されることがほとんどないため、私の知る限り、SQLエコシステムにそのようなツールは存在しません。
3. GraphQLは信頼境界を越えて利用されるように設計されている
おそらくより重要なのは、SQLエンドポイントは組織間の信頼境界(trust boundaries)を越えて消費されるように設計されていないということです。たとえば、読み取り専用のブロックチェーンデータを提供するためにSQLを使用している場合、過度に複雑なSQLクエリ一つでデータベースを低速化させ、他の誰もが使用できない状態に陥れる可能性があります。
GraphQLもバックエンドで任意に負荷の高い計算を引き起こすほど強力ですが、SQLとは異なり、この問題への対処は初日から焦点となってきました。高負荷なクエリを動的にブロックしたり、クライアントをスロットリングしたりするための研究やツールが増え続けています。
一方、SQLでこの問題を解決するための従来のアプローチは、遅いクエリを手動で見つけて書き直すというものでした。あるいは、インデックスを追加したり、データベーススキーマを変更したりして、「承認された」高負荷クエリの影響を軽減することもあります。それが組織におけるSQLの導入のあり方であり、エンドポイントを直接クエリできるのは、厳密に制御されたグループやサービスだけでした。
GraphQLの組織横断的なDNAが光るもう一つの点は、スキーマイントロスペクション(自己探査)です。GraphQLはスキーマイントロスペクションを言語の第一級の関心事として扱っています。
たとえば、GraphQLのRoot型には_schemaフィールドがあり、これを使用してクエリ可能な型を調査できます。
// GraphQL request
query {
**schema {
types {
name
description
fields {
name
}
}
}
}// JSON response
{
"data": {
"**schema": {
"types": [
{
"name": "Root",
"description": null
},
{
"name": "User",
"description": "A user of the platform."
"fields": [
{ "name": "name" },
{ "name": "id" }
]
},
{
"name": "Organization",
"description": "An organization of the platform."
"fields": [
{ "name": "name" },
{ "name": "id" }
]
}
 ]
}
 }
}
SQLを公平に評価すれば、一部のイントロスペクションクエリは非常に恐ろしい見た目になりますが、構文に慣れていれば、上記とほぼ同等のイントロスペクションはそれほど悪くはありません。
SELECT c.table_schema,c.table_name,c.column_name,pgd.description
FROM pg_catalog.pg_description pgd
RIGHT JOIN information_schema.columns c on
(pgd.objsubid=c.ordinal_position)
WHERE c.table_schema NOT IN ('pg_catalog', 'information_schema');
しかし、このSQLクエリはPostgresデータベース向けのベンダー固有パラメータでいっぱいです。MySQLデータベース向けの同等のクエリは異なるものになります。また、上記のクエリをプレーンテキストとして読むのは簡単ですが、そのクエリを送信してレスポンスを受け取るには、ベンダー固有のSQLのフレーバー、通信プロトコル、ODBC、あるいはそれらの組み合わせを理解するベンダー固有のCLIクライアントやクロスベンダーのデスクトップGUIといった特別なツールが必要です。
対照的に、GraphQLはイントロスペクションクエリを含むすべてのクエリに対して、HTTP経由でプレーンテキストのJSONを返します。そのため、PostmanやChrome Dev Tools、あるいはすべてのMacやLinuxのOSターミナルにプリロードされているシンプルなcurlコマンドで、エンドポイントを試すことができます。
結論
私が強調したRESTやSQLの欠点の多くに、救済策がないわけではないのは事実です。RESTful APIでオーバーフェッチやアンダーフェッチの問題を解決しようとする試みもありました。RESTful APIにスキーマを追加する試みもあり、理論的には定義されたエンドポイントから提供することも可能です。SQLもまた、単なるクエリ言語であり実装ではないため、HTTPを使用し、プレーンテキストのCSVやJSONを返し、より理にかなったイントロスペクション機能を備えたSQLインターフェースを構築することを妨げるものは何もありません。しかし、ブロックチェーンやコンテンツアドレス指定型ストレージネットワークが可能にしたように、組織間の信頼境界を越えて任意のデータを効率的に直接クエリすることは、これら二つの技術のDNAには単に含まれていないのです。
一方、GraphQLは、最初からこのユースケースのために設計されました。高度なイントロスペクションのためのユーザーフレンドリーなGUIや、ブラウザ内のUIコンポーネントにGraphQLクエリを宣言的にバインドすることをほぼシームレスにする成熟したツールなど、フロントエンドエンジニアを念頭に置いて設計されました。dAppが主にブロックチェーン上で動作するスマートコントラクトとインターフェースするブラウザアプリで構成されるパラダイムにおいて、フロントエンドエンジニアのニーズと嗜好は、分散型ウェブのテクノロジースタックを決定する原動力となるでしょう。EthereumのJSON RPC APIの前にGraphQLインターフェースを置こうとする複数の試みがすでに見られるのは、そのためです。
The Graphでは、ブロックチェーンの上にコンシューマーグレードのパフォーマンスを備えた豊かなユーザー体験を構築することが、ブロックチェーンと分散型ウェブの普及を達成するための主要なハードルの一つであると考えています。そのため、昨年7月に、開発者がGraphQLインターフェースを介して分散型アプリケーションのためにEthereumとIPFSのデータを効率的にクエリできるインデックスサーバーをオープンソース化しました。将来、ブロックチェーン上のデータサイエンスや機械学習のための分析パイプラインがより一般的なユースケースになれば、SQLや、あるいは他のクエリ言語……たとえばDatalogなどのサポートも検討することになるでしょう。
出典: Mediumの GraphQL Will Power the Decentralized Web より
このページに関わるもの
用語
-
GraphQL
呼び出す側が欲しいデータの形を指定し、その形で返るクエリ言語。ここで重要なのは、OCAP がこれを用いて、チェーンごとにクライアントを用意せずに一つのインターフェースでチェーンデータを問い合わせられるようにしている点です。