ブロックチェーン業界にデータ分析が重要なのはなぜか?
著者: Riley Shu(ArcBlock データエンジニア)
「ブロックチェーン」と「データ分析」を結びつけることは、人々にとって直感的ではないかもしれません。ArcBlock のようなブロックチェーンのスタートアップに、なぜデータ分析が必要なのでしょうか?どのようなデータを分析するのでしょうか?今日は、オンチェーンデータ分析の価値について私たちの見解を共有し、ArcBlock のデータパイプラインを少しご紹介します。データは ArcBlock の中核的な製品とサービスの一部であるだけでなく、私たちが下すすべての意思決定の基盤でもあります。
データとは?
まず、データの定義について認識を合わせましょう。データとは、観察、実験、または計算から得られる、定性的または定量的な変数の値の集合です。一般に、データは人間が残す痕跡であり、人々の行動や活動に関する詳細な情報を含みます。データを収集して分析することで、これまで問われたことのない疑問を提起し、その答えを得ることもできます。現在、ArcBlock はオンチェーンデータ、製品データ、システムログという 3 種類のデータを使用しています。
ArcBlock におけるデータ分析も、次の 3 つの分野を対象としています。
- オンチェーンデータ分析
- 製品・ユーザーデータ分析
- セキュリティ監査
オンチェーンデータ分析
不変性はブロックチェーンの中核的な特徴の一つです。つまり、取引が一度チェーンに記録されると、それを変更したり元に戻したりすることはできません。ブロックチェーンは誰もが閲覧できる公開取引台帳のようなもので、アドレスさえ分かれば、そのアドレスが関与したすべての取引の完全な履歴にアクセスできます。
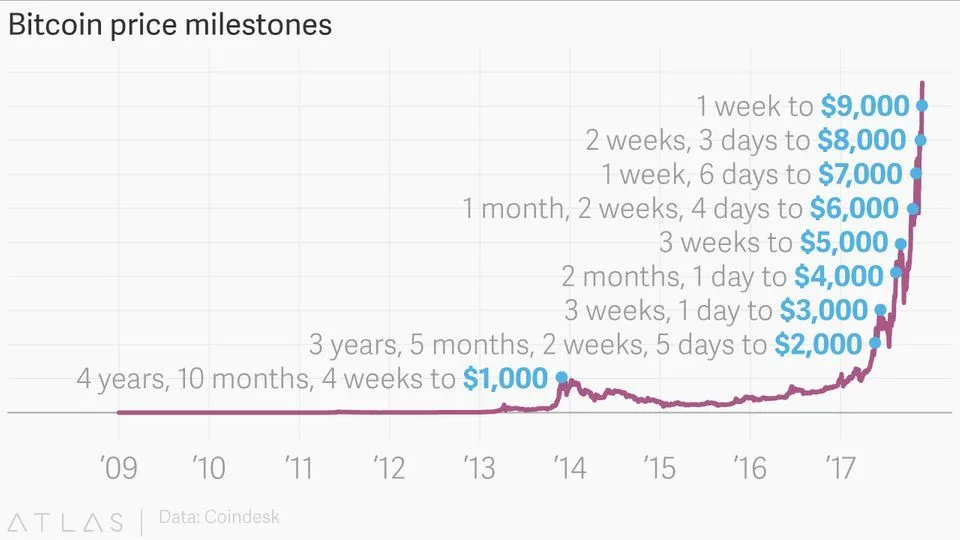
2017 年以降、ビットコインの価格は一直線に上昇し、取引プラットフォームとして利用したり、ブロックチェーンの別の可能性を探ったりする人が増え続けています。関心の高まりによって、ビットコインデータの種類と内容は豊かになりました。2009 年から現在までに、ビットコインには約 17 億件の取引が保存されています。
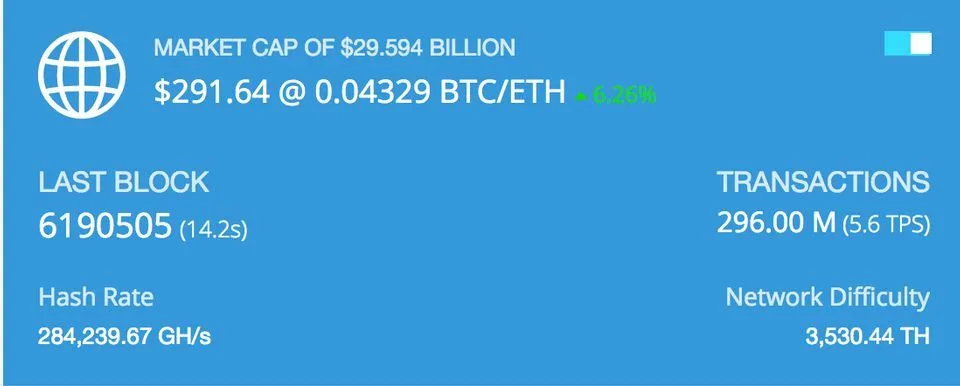
2015 年に誕生した、より新しいイーサリアムでさえ、すでに 600 万以上のブロックを保存しており、12 秒ごとに価値あるデータを含む新しいブロックが生成されています。
これらのデータはユーザーの金融行動を表し、大量の情報を内包しています。そこから多くの興味深い問いを立てることができます。資金はどこから来るのか?どこへ行くのか?資金全体の流れはどうなっているのか?異常な行動を示すアドレスはどれか?
公開されているこれらのデータについて、市場が分析レポートであふれていないのはなぜでしょうか?一つの説明は、ブロックチェーンが分散型であるため、一般の人々がそのようなレポートを作成する動機が十分にないことです。もう一つの理由は、ブロックチェーンデータの分析には複雑なデータ構造やアルゴリズムについて一定の知識が必要であり、データを掘り下げ始めようとする人にとって敷居が高く感じられることです。
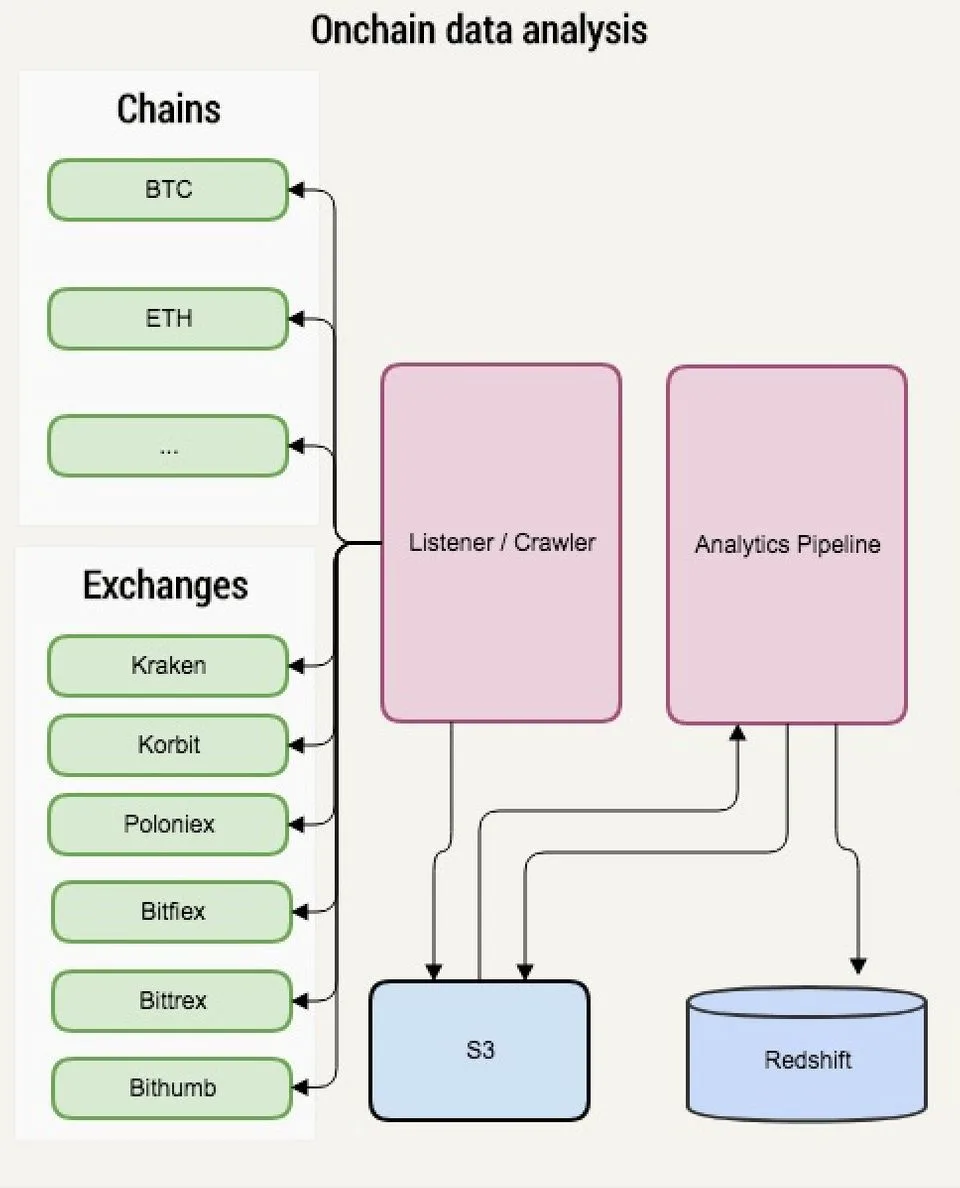
データをより適切に分析するため、私たちはビットコインとイーサリアムのデータをインデックス化し、データを最新の状態に保つリアルタイムのデータリスナーを稼働させています。以前の記事では、オンチェーンデータをどのようにインデックス化したかを紹介しました。データ処理では、AWS Kinesis を使用してデータを parquet 形式へストリーミングし、S3 に保存しています。同時にデータは私たちのデータパイプラインにも送られ、Apache Spark を使用してクリーニングと集約を行い、集約したデータを Redshift に送信します。そこで、さらなるクエリや可視化に利用できる状態になります。
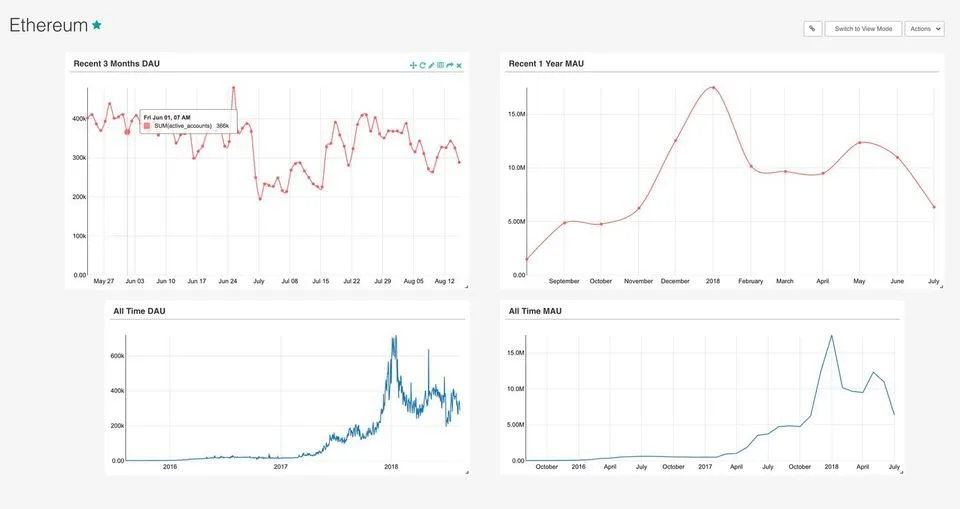
現在は Apache Superset を使用して、イーサリアムの DAU(デイリーアクティブユーザー)と MAU(マンスリーアクティブユーザー)を可視化しています。今後は、ユーザー継続率やコールドウォレット数など、オンチェーンデータ分析の可視化をさらに追加していく予定です。
製品・ユーザーデータ分析
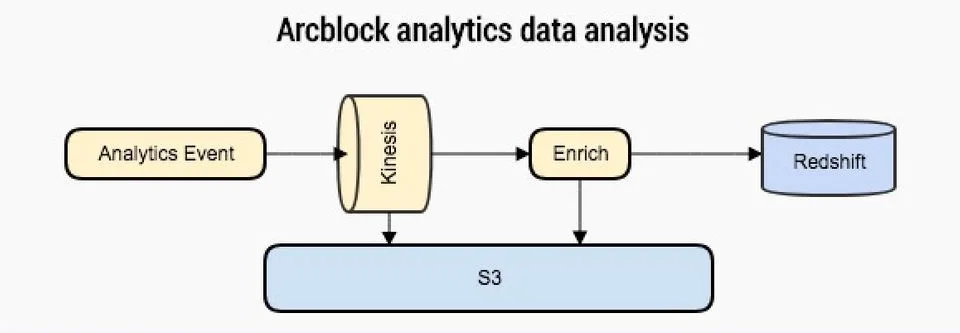
より良いサービスの鍵は、ユーザーを理解することです。新機能のうち何を優先すべきか、どのようなウェブサイトのレイアウトが最高のユーザー体験をもたらすかなど、製品開発の過程では多くの意思決定が必要です。ユーザーへの理解が深まるほど、ユーザーの問題を解決するために正しい判断を下せる可能性が高まります。ArcBlock では、すべての意思決定プロセスを追跡可能にする必要があります。そのため、データはユーザーが実際に考えていることを映し出すものであり、データは決して嘘をつかないという確信のもと、データを指針として活用しています。
データの重要性を踏まえ、ArcBlock は当初からデータインフラストラクチャに多くの注意を払ってきました。ユーザー・製品データパイプラインは、リアルタイムのユーザーデータを取得して S3 にバックアップし、Spark を使用して集約します。計算が完了すると、パイプラインはさらなる分析作業のためにデータを Redshift へ送信します。このパイプラインはオンチェーンデータパイプラインと似ていますが、開発する機能が増えるにつれて、私たちのパイプラインも最適化されていきます。
セキュリティ監査
ブロックチェーンは新世代ネットワークを構築するためのインフラストラクチャとして機能し、安全性は常に最優先事項です。セキュリティネットワークインフラストラクチャを慎重に設計するだけでなく、データ分析を用いてユーザーの異常行動を検知し、悪意ある行動が深刻な損害を引き起こす前に阻止しています。
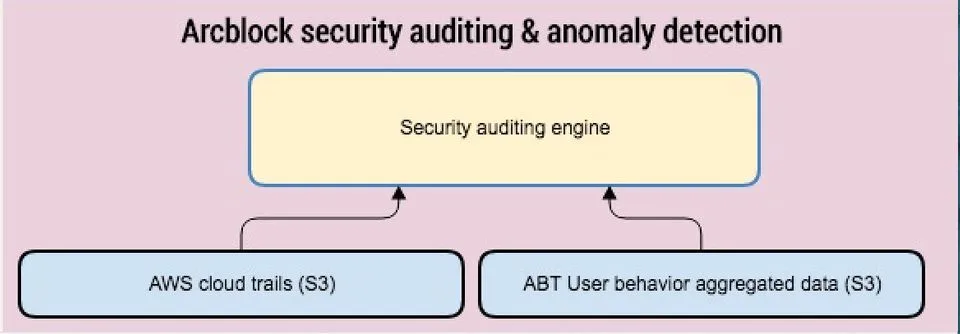
すべてのシステムログは S3 に保存されます。分析エンジンは履歴データと現在のデータを比較し、機械学習のパターンを使用して取引の異常を検知します。異常が見つかると、システムは管理者に警告を送信し、疑わしい操作は自動的に停止されます。
今日は、ArcBlock がデータを活用する 3 つの方法を簡単に紹介しました。ブロックチェーンの過去と未来について語るとき、既存の問いであれ、まだ提起されていない問いであれ、データは常に答えを持っています。私たちがすべきことは、必要な情報を収集し、真実を明らかにすることだけです。
このページに関わるもの
製品
-
OCAP
active
チェーンごとにクライアントを用意するのではなく、一つのインターフェースでチェーン上のデータを問い合わせるためのプロトコル。ArcBlock が関連特許を保有しています。