COAP実装の詳細解説(1):Bitcoinデータの解析方法
著者: Peiling Ding(ArcBlockソフトウェアエンジニア、OCAPプロジェクトリードデベロッパー)
ArcBlockのオープンチェーンアクセスプロトコル(OCAP)の技術的詳細をコミュニティが理解できるよう、エンジニアリングチームはOCAPの設計と開発を「解読」する技術記事を定期的に執筆し、読者がこれらの概念をより深く理解できるよう努めます。この知識があれば、開発者はより多くのOCAPチェーンアダプターの実装に参加でき、OCAPがより多くのブロックチェーンプロトコルをサポートできるようになります。
いつものように、設計の改善に関するフィードバックを歓迎します。
なぜBitcoinデータを解析するのか?
私たちは予定通り、7月末にOCAPの最初のバージョンをリリースしました。このバージョンでは、OCAPはBitcoinデータのクエリサービスを提供しています。ユーザーはハッシュを使ってブロックのトランザクション情報を素早く照会できるだけでなく、複雑なカスケードクエリも実行できます。たとえば、特定の2つのアドレス間のトランザクションを照会することが可能です。以下のクエリは、有名な「ピザ取引」を返します。
{
  transactionsByAddress(sender: "17SkEw2md5avVNyYgj6RiXuQKNwkXaxFyQ", receiver: "13TETb2WMr58mexBaNq1jmXV1J7Abk2tE2") {
    data {
      blockHeight
      hash
      total
      numberInputs
      numberOutputs
    }
  }
}
ネイティブのBitcoin APIはこのようなデータクエリをサポートしていないため、OCAPがこのようなクエリ機能を持つためには、Bitcoin上のデータを前処理し、私たちが望む形で保存しなければなりません。これが今日のテーマ、つまりBitcoinデータをどのように解析するか、という話につながります。
概要
技術的な詳細に入る前に、私たちがやろうとしていることの基本を確認しましょう。わかりやすくするために、検索エンジンと比較してみます。
ご存知のように、インターネット上のデータは複雑であり、この無限のデータの海の中から、検索エンジンはユーザーが求める結果を素早く見つけ出すことができます。それが可能な理由は、検索エンジンの背後に2つのコンポーネントがあるからです。インターネットクローラーと転置インデックスです。クローラーはインターネットから継続的にデータを収集する役割を担い、転置インデックスは検索エンジンが素早くクエリできる特定の形式でデータを保存する役割を担います。
本質的に、ArcBlock OCAPがサポートするブロックチェーンクエリは、ブロックチェーンに「検索エンジン」サービスを提供することと同等であり、同様のデータ前処理が必要です。検索エンジンとは異なり、Bitcoinのデータはノードのディスクにバイナリ形式で保存されているため、クローラーは必要ありません。しかし、データの構成方法は人間にとってあまり親切ではないため、これらのバイナリデータを読み取り、元の姿に復元するパーサーが必要です。そして、OCAPが必要とする形でデータを形成するために、解析されたデータにさらなる処理を施す必要があります。
技術的詳細
このセクションでは、Bitcoinのデータがどのように保存されているか、そして生のバイナリファイルからこのデータを解析した後にどのような追加計算が必要かに焦点を当てます。
Bitcoinデータの保存方法
データを保存するファイル
Bitcoinの元データは $HOME/.bitcoin/blocks 以下にあります。このディレクトリには主に2種類のファイルがあります。1つは blk00952.dat(または類似のもの)、もう1つは rev000952.dat(または類似のもの)です。「blk」で始まる最初の種類のファイルはBitcoinのソースデータを保存するものであり、2番目のものは巻き戻し(rewind)に使用されます。巻き戻しファイルについては次回お話しします。今は、ソースデータファイルに焦点を当てましょう。
まず、以下のコマンドでこれらのファイルに何が保存されているかを確認してみましょう。
od -x --endian=big -N 297 -An blk00000.dat f9be b4d9 1d01 0000 0100 0000 0000 0000
0000 0000 0000 0000 0000 0000 0000 0000
0000 0000 0000 0000 0000 0000 3ba3 edfd
7a7b 12b2 7ac7 2c3e 6776 8f61 7fc8 1bc3
888a 5132 3a9f b8aa 4b1e 5e4a 29ab 5f49
ffff 001d 1dac 2b7c 0101 0000 0001 0000
0000 0000 0000 0000 0000 0000 0000 0000
0000 0000 0000 0000 0000 0000 0000 ffff
ffff 4d04 ffff 001d 0104 4554 6865 2054
696d 6573 2030 332f 4a61 6e2f 3230 3039
2043 6861 6e63 656c 6c6f 7220 6f6e 2062
7269 6e6b 206f 6620 7365 636f 6e64 2062
6169 6c6f 7574 2066 6f72 2062 616e 6b73
ffff ffff 0100 f205 2a01 0000 0043 4104
678a fdb0 fe55 4827 1967 f1a6 7130 b710
5cd6 a828 e039 09a6 7962 e0ea 1f61 deb6
49f6 bc3f 4cef 38c4 f355 04e5 1ec1 12de
5c38 4df7 ba0b 8d57 8a4c 702b 6bf1 1d5f
ac00 0000 00f9 beb4 d900上に表示されているデータはBitcoinのジェネシスブロックです。これはバイナリデータ(16進数)であり、2文字で1バイトを表します。「blk」ファイルはこのような複数のブロックで構成されています。各「blk」ファイルのサイズ上限は128MBです。ファイルが最大許容サイズに達すると、Bitcoinプログラムは新しいブロックを保存するために別のファイルを作成します。
一見すると混乱しているように見えますが、データ形式を理解すれば、それほど難しくはありません。
データ保存構造
Bitcoinはウェブサイト上でデータ形式について詳しく説明していますが、ドキュメントの構成は読みやすく理解しやすいものではないため、私たちはより直感的な図を作成しました。
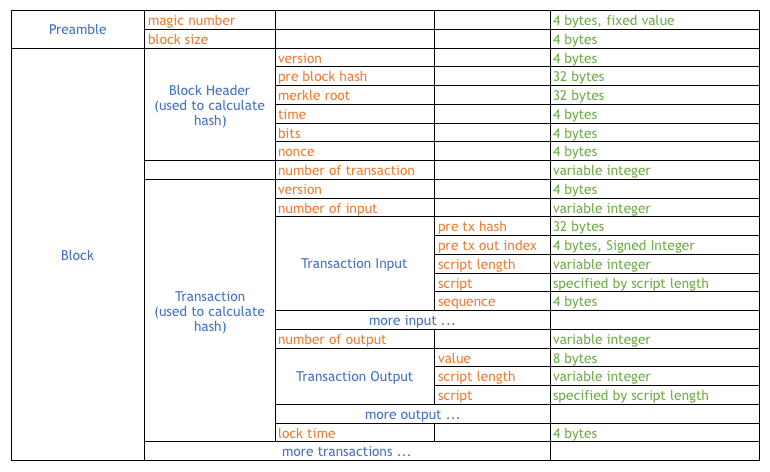
図の説明:
- 上の図では、青は複合データ型、オレンジは単純データ型、緑は注釈を表します。
- この図はセクションを表しており、blkxxxデータファイルは多くのセクションで構成されています。
- 各セクションはプリアンブルとブロックで構成されています。ブロックはブロックヘッダー、トランザクション数、およびそれらのトランザクションで構成されています。各トランザクションはいくつかの単純データ型といくつかのトランザクション入力/出力で構成されています。以下同様です。
- ほぼすべてのデータはリトルエンディアンで保存されていますが、トランザクション入力/出力のスクリプトは例外で、ビッグエンディアンで保存されています。
- マジックナンバーは固定値で、0xD9B4BEF9 です。
- 可変整数の長さは不定で、1バイトから9バイトの間です。解析の詳細なルールは以下の通りです:
- 最初のバイトが253未満の場合、そのバイトが表す値を直接返す
- 最初のバイトが253に等しい場合、次の2バイトを戻り値として読み取る
- 最初のバイトが254に等しい場合、次の4バイトを戻り値として読み取る
- 最初のバイトが255に等しい場合、次の8バイトを戻り値として読み取る
Bitcoinのジェネシスブロックデータをこのチャートにあてはめると、次のようになります:
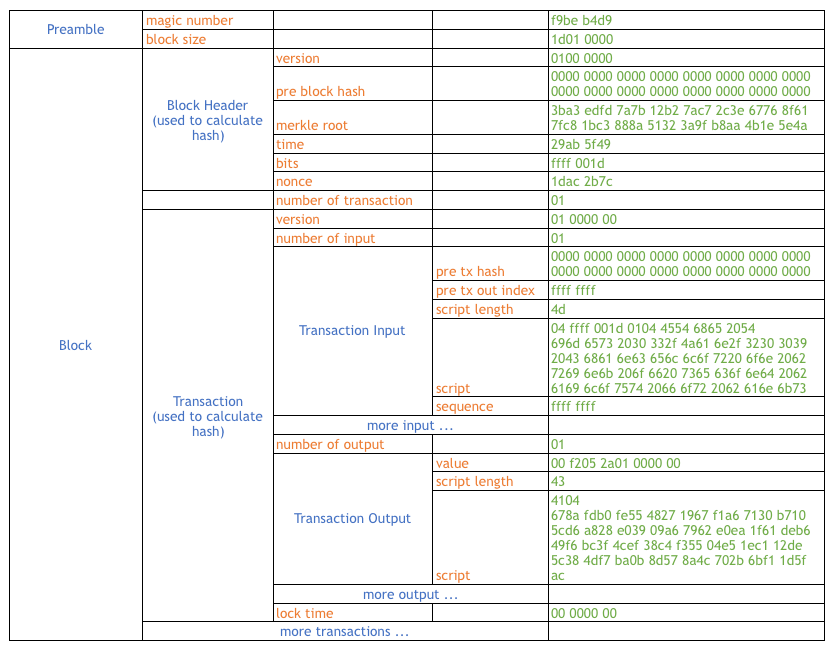
これにより、データ形式の謎がかなり解けます。なお、データをビッグエンディアンに変換していません。確認したい場合は、ご自身で変換してください。
追加フィールドの計算
この図の表示には、ブロックハッシュ、ブロック高、トランザクションハッシュ、アドレスなど、いくつかの非常に重要なフィールドが含まれていないことに気づいた方もいるかもしれません。Bitcoinの父であるサトシ・ナカモトは、Bitcoinを設計する際に非常に「けち」でした。データが計算可能であれば、チェーンには保存されません。これはブロックチェーンの重要な特徴であり、多くのディスクスペースを節約できますが、追加の作業が必要になります。これらのデータを自分たちで算出する必要があります。それでは、それぞれの値をどのように計算するかについて説明しましょう。
ブロックハッシュとトランザクションハッシュの計算
ブロックハッシュとトランザクションハッシュの値は同じアルゴリズムから導出されます。両者の唯一の違いは、計算に使用されるデータです。ブロックハッシュの場合、入力データはブロックヘッダーの80バイトですが、トランザクションハッシュの場合はトランザクションデータ全体です。これは、ブロックヘッダーにマークルルートが含まれているため、ブロックハッシュの計算にはブロック全体が不要だからです。
ハッシュ値は入力データに対して2回のSHA-256演算を行うことで導出されます。擬似コードは以下の通りです:
hash = sha256 (sha256 (data))ブロックヘッダーとトランザクション全体をそれぞれ上記の式に代入することで、対応するハッシュ値を得ることができます。
ブロック高の計算
ご存知のように、Bitcoinの生データはblkxxxxxx.datに保存されており、各データファイルには多くのブロックが含まれています。バイト0から順番に読み取り、すべてのブロックを解析すると、ブロックが順番に並んでいないことがわかります。たとえば、「blk」ファイルから177番目のブロックを読み出す前に178番目のブロックを読み取ることがあります。その理由を理解するには、BitTorrentで何かをダウンロードしているときのプログレスバーがどのようなものだったかを考えてみてください。正しいブロック高を得るためには、ブロックをソートしなければなりません。
ブロックチェーンに詳しい方なら、ブロックチェーンのデータ構造は逆向きの単方向連結リストであることをご存知でしょう。ブロックハッシュと前のブロックハッシュを使ってこれらのブロックを再結合することができます。ジェネシスブロックの前のブロックハッシュは0に固定されています。
アドレスの計算
「ピザ取引」の例のようなアドレスベースのクエリをサポートするためには、各トランザクションの支払者と受取人のアドレスを見つけなければなりません。この2つのデータは、それぞれトランザクション入力と出力のスクリプトフィールドに含まれています。解析には異なる戦略を使用する必要があります:
- トランザクション出力については、公開鍵または公開鍵ハッシュを見つけ、特定のアルゴリズムに従ってアドレスを計算します。
- トランザクション入力については、対応する前のトランザクション出力からアドレスを取得します。
トランザクション出力については別の記事で詳しく取り上げますが、今はトランザクション入力に焦点を当てましょう。
トランザクション入力から公開鍵を取得することはできますが、トランザクション入力のスクリプトから直接アドレスを計算することはお勧めしません。これは、Segregated Witnessの登場後、アドレスの計算方法が変わったためです。入力から直接アドレスを解析すると、前のトランザクション出力とは異なるアドレスになる可能性が非常に高いです。簡単に言えば、Matという名前でコインを受け取り、Matthewという名前で使ったとします。MatとMatthewは同一人物ですが、このエラーにより、データベースにMatの正しいレコードが1件ではなく、誤ったレコードが2件残ってしまう可能性が非常に高くなります。
まとめ
上記のすべての手順を経て、OCAPデータ前処理の最初のステップ、つまりデータの解析が完了しました。この後、BitcoinのUTXOプール全体を取得し、各アドレスのトランザクション数や残高などの統計を計算するために、Bitcoinの歴史を再解釈する必要があります。
ブロックチェーンの父として、サトシ・ナカモトはBitcoinを設計する際に多くの素晴らしいアイデアを持っており、細部へのコントロールは驚くべきものでした。このプロジェクトでは、実践しながら学んでおり、多くのことを学びました。時間があれば、生データを解析するコードを書いてみることで、あなたも多くのことを学べるでしょう。これはBitcoinを徹底的に理解するための最も効果的な方法です。
まず、以下のコマンドでこれらのファイルに何が保存されているかを確認してみましょう。
このページに関わるもの
製品
-
OCAP
active
チェーンごとにクライアントを用意するのではなく、一つのインターフェースでチェーン上のデータを問い合わせるためのプロトコル。ArcBlock が関連特許を保有しています。